Een model is nog geen oplossing
Een nieuw model kan beter redeneren, langere context verwerken of sneller antwoorden. Dat zijn nuttige eigenschappen, maar ze vertellen nog niet of een toepassing in jouw organisatie gaat werken.
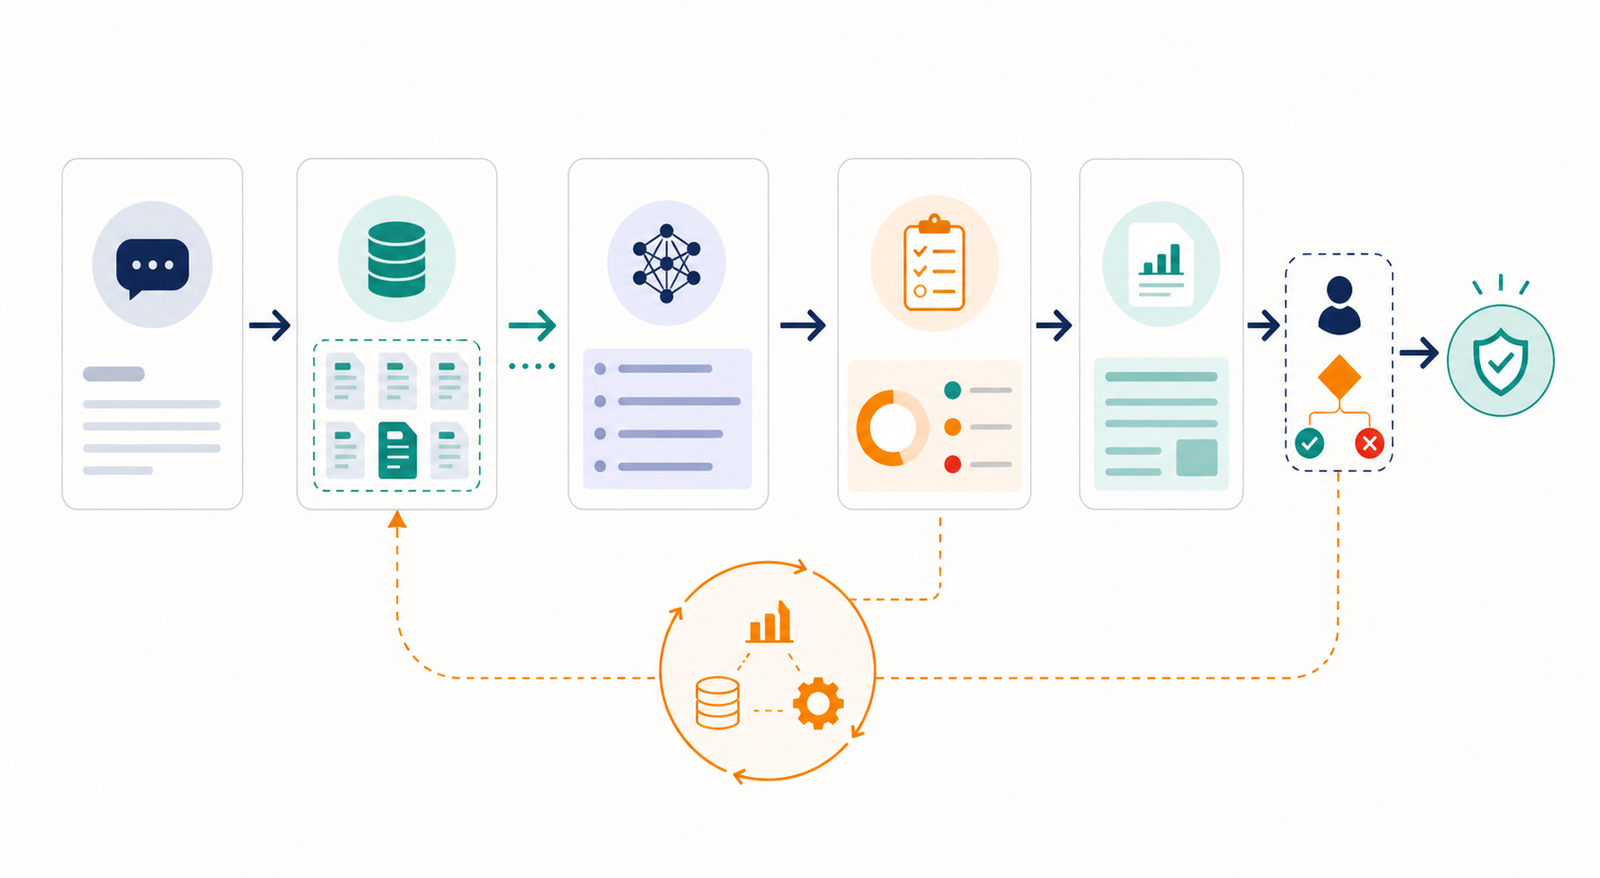
Een LLM krijgt pas betekenis wanneer het onderdeel wordt van een route: informatie ophalen, een beslissing voorbereiden, een actie uitvoeren en iemand de uitkomst laten controleren. De kwaliteit van die route bepaalt mede of een model in de praktijk bruikbaar wordt.
Context maakt het verschil
Veel praktische problemen ontstaan niet doordat een model niets weet. Ze ontstaan doordat het model niet de juiste informatie op het juiste moment krijgt. RAG, goede bronselectie en duidelijke instructies zijn daarom geen losse trucjes, maar onderdelen van dezelfde ontwerpkeuze.
- Welke bronnen zijn betrouwbaar genoeg om te gebruiken?
- Hoe weet je of de opgehaalde context relevant is?
- Wat moet er gebeuren als informatie ontbreekt of elkaar tegenspreekt?
Als je die vragen niet beantwoordt, bouw je al snel een demo die vooral overtuigt zolang iemand precies de verwachte vraag stelt.
Begin bij een terugkerende beslissing
Een praktische start is vaak geen chatbot voor alles. Zoek een terugkerende stap waar mensen veel tijd verliezen aan lezen, vergelijken, samenvatten of controleren. Maak daar een kleine route van met een duidelijke invoer, een controleerbare uitvoer en een eigenaar die kan ingrijpen.
Daarna kun je meten wat er werkelijk verandert: minder zoektijd, minder overdrachten, een kortere doorlooptijd of betere voorbereiding. Pas wanneer dat helder is, heeft het zin om meer modellen, tools of agents toe te voegen.
Test met representatieve voorbeelden
Maak vóór een modelwissel of promptwijziging een vaste set voorbeelden uit het echte werk. Leg per voorbeeld vast wat acceptabel is, welke bronnen mogen worden gebruikt en welke fout onveilig of onbruikbaar is.
Draai dezelfde evaluatie opnieuw na iedere relevante wijziging. Zo vergelijk je gedrag in plaats van losse indrukwekkende antwoorden. De officiële OpenAI-richtlijnen adviseren hetzelfde basisprincipe: gebruik representatieve taken en voer bestaande evaluaties opnieuw uit wanneer je een model vergelijkt of migreert.
Mijn praktische filter
Bij iedere nieuwe AI-mogelijkheid stel ik drie vragen: welk probleem lost dit op, in welke stap van het proces gebeurt dat, en hoe merken we dat het werkt? Als daar geen concreet antwoord op komt, is het waarschijnlijk nog inspiratie — geen implementatie.
Voor een volgende stap kun je lezen hoe context, tools en evaluatie samenkomen in een productie-agent of hoe coding agents in een ontwikkelworkflow passen. Wil je dit vertalen naar een eigen proces, bespreek dan je AI-vraagstuk.
Bronnen
- OpenAI — Model selection and migration guidance: officiële richtlijnen voor representatieve taken, relevante tools en het opnieuw uitvoeren van evaluaties bij modelvergelijking (geraadpleegd 21 augustus 2026).
- OpenAI API — Evaluation best practices: officiële richtlijnen voor representatieve evaluaties, graders en het vergelijken van model- en systeemgedrag (geraadpleegd 21 augustus 2026).
- OpenAI API — Prompt engineering: officiële richtlijnen voor duidelijke instructies en het beheren van context in modelinteracties (geraadpleegd 21 augustus 2026).