Beoogde publicatiedatum: 2026-10-09 · Laatst bijgewerkt: 2026-10-09 · Auteur: Joost Heijden
Een agent kan een overtuigende samenvatting, patch of tooluitkomst produceren terwijl de kernclaim fout is. De vraag is daarom niet alleen “welke test is groen?”, maar “welke concrete claim ondersteunt dit bewijs, binnen welke scope en met welke restonzekerheid?” Een schema-validator, domeinexpert, integratietest en production trace controleren verschillende eigenschappen.
Dit is een neutraal verificatiepatroon met volledig synthetische voorbeelden. Er is geen agentrun, klantoutput of meetresultaat uitgevoerd. De matrix helpt vooraf te besluiten wat nodig is voordat iemand op “approved” drukt.
Waarom is een groene pipeline niet genoeg?
Een groene pipeline bewijst alleen dat de checks die erin staan, onder hun eigen voorwaarden, groen werden. Een JSON-schema kan verplichte velden en datatypes controleren, maar niet of een beschreven businessregel waar is. Unit tests testen de gekozen gevallen; een domeinreview controleert betekenis; traces tonen geïnstrumenteerde gebeurtenissen die daadwerkelijk zijn vastgelegd.
Microsofts verificatiekader benoemt drie deelnemers: mensen, AI en deterministische tools. Het laat zien waarom ze elkaar aanvullen: een pipeline kan compileren terwijl het resultaat inhoudelijk onjuist is, en menselijke review levert pas bruikbaar bewijs op wanneer vooraf duidelijk is wat de reviewer moet bevestigen of corrigeren. De auteur noemt dit een opinionated framework, geen norm voor elk domein.
Hoe bouw je een claim-naar-bewijsmatrix?
Schrijf eerst de claim in één controleerbare zin, daarna de check en de passconditie. Noteer ook wie de controle uitvoert, het resultaatbestand, wat de check niet bewijst en welke actie volgt bij mislukking. Dat voorkomt dat “QA geslaagd” als los label meer betekenis krijgt dan de onderliggende controle.
Onderstaande fictieve matrix toont het patroon:
| Claim | Check en eigenaar | Passcriterium | Bewijsartifact | Wat dit niet bewijst | Bij mislukking |
|---|---|---|---|---|---|
| De agent levert JSON met de afgesproken velden. | JSON Schema-validator; CI. | Schema valideert de volledige response. | Validatorversie, inputhash en resultaat. | Dat waarden waar of volledig zijn. | Stop release; corrigeer vorm of contract. |
| De voorgestelde code behoudt de beschreven functie. | Unit- en integratietests; engineer. | Vooraf gekozen cases slagen in een schone checkout. | Commit, testlog en fixtureversie. | Gedrag voor niet-geteste inputs of echte productievolumes. | Houd merge tegen; maak ontbrekende case expliciet. |
| De samenvatting noemt alleen bestaande configuratiesleutels. | Existencecheck plus reviewer die output met bronbestand vergelijkt. | Iedere sleutel bestaat; reviewer markeert claim als bevestigd of gecorrigeerd. | Lijst van claims, bronlocatie en reviewbesluit. | Dat elk effect of iedere interpretatie klopt. | Laat claims corrigeren en review opnieuw uitvoeren. |
| De toolcall wijzigde geen record buiten de toegestane case. | Geïsoleerde integratietest plus event-/tracecontrole; platform owner. | Denied call leverde geen write-event en geen state-diff op. | Request-id, policybesluit, toolstatus en voor/na-state. | Dat productie dezelfde volledige observability of dekking heeft. | Blokkeer release; onderzoek bypass en ontbrekende logging. |
| De service vertoonde geen verboden call in de geobserveerde periode. | Query over geïnstrumenteerde traces; SRE/security. | Geen passende events binnen de gedefinieerde dataset en periode. | Query, tijdvenster, sampling/retentie en resultaatsnapshot. | Dat de call nooit plaatsvond buiten zichtbare telemetry. | Gate niet groen; herstel dekking of behandel als onbekend. |
Een check zonder een resultaat dat iemand kan beoordelen, laat weinig herhaalbaar bewijs achter. Vervang “expert heeft nagekeken” door bijvoorbeeld “de expert bevestigde of corrigeerde ieder item in deze claimlijst; dit bestand bevat de annotaties en open punten”. Daarmee is ook zichtbaar welke onderdelen nooit zijn beoordeeld.
Welke claim past bij welke testlaag?
Kies de goedkoopste laag die de claim daadwerkelijk kan aantonen, en voeg een sterkere laag toe wanneer impact of onzekerheid dat vraagt. Een syntaxclaim vraagt iets anders dan een financiële beslissing of een onomkeerbare write. De lagen vormen geen universele ranglijst: een dure trace-query is niet automatisch sterker bewijs voor semantische waarheid dan een goed afgebakende domeinreview.
| Laag | Goede vraag | Typisch bewijs | Belangrijke grens |
|---|---|---|---|
| Schema en bestaan | Voldoet output aan het contract en verwijzen namen naar bestaande entiteiten? | Validatorrapport, diff of source lookup. | Geen semantiek, intentie of volledigheid. |
| Deterministische test | Blijft de code correct voor vooraf beschreven gevallen? | Testresultaat, fixtures en commit-id. | Alleen coverage van de gekozen scenario's en aannames. |
| Integratie- of denytest | Werken componenten samen en wordt de verboden actie geweigerd? | Request, policybesluit, state-diff en logs. | Een testomgeving is niet vanzelf identiek aan productie. |
| Domeinreview | Kloppen de geëxtraheerde regels of interpretaties voor de beoordeelde scope? | Bevestigde/gecorrigeerde claimlijst met reviewer en datum. | Alleen het bekeken bereik; expertise en bron kunnen beperkt zijn. |
| Runtime trace | Welke geïnstrumenteerde bewerkingen zijn langs dit pad waargenomen? | Trace- en spanquery plus dekking, periode en sampling. | Geen zicht op niet-geïnstrumenteerde of niet-waargenomen paden; geen bewijs van inhoudelijke juistheid. |
OpenTelemetry beschrijft traces als requestpaden door toepassingen en spans als eenheden van werk met context en attributen. Dat helpt gebeurtenissen correleren. Het geeft geen waarheidslabel aan de inhoud van een agentresponse. Een query “geen denied write gezien” is alleen betekenisvol als je weet welke tools geïnstrumenteerd zijn, welke periode is bewaard en of sampling gebeurtenissen kan weglaten.
Wat bewijst een production trace wel en niet?
Een trace kan laten zien welke geïnstrumenteerde bewerkingen in een opgenomen requestpad voorkwamen, in welke volgorde en met welke contextvelden. Die observatie kan een concrete claim staven, zoals “deze request-id riep de betaaltool niet aan”, wanneer de tool volledig en betrouwbaar is geïnstrumenteerd.
Een trace bewijst niet vanzelf dat er geen ander pad bestaat, dat alle events zijn geëxporteerd of dat toolresultaten inhoudelijk correct zijn. Leg daarom query, tijdvenster, sampling, retentie, services en ontbrekende spans vast. Beperk trace-attributen tot noodzakelijke metadata; zet geen prompts, tokens, klantinhoud of secrets in telemetry om “meer bewijs” te verzamelen.
Hoe maak je menselijke review reproduceerbaar?
Geef een reviewer kleine concrete claims en een bron of verwacht resultaat om tegen te toetsen. Vraag per claim om bevestiging, correctie of “onbeslist”, en leg reden, bereik, reviewer en datum vast. “Ziet er goed uit” is geen controleerbare status voor een releasebesluit.
Begin met een risicogebaseerde steekproef als het volledige bereik te groot is, maar label de uitkomst dan als steekproef. Trek geen conclusie over alle outputs uit een paar gecontroleerde voorbeelden. Definieer vooraf wat er gebeurt bij een fout: extra review, kleinere rollout, extra deterministische test of stop.
Hoe vertaal je resterend risico naar een releasegate?
Maak de gate afhankelijk van noodzakelijke bewijsrijen en hun restrisico, niet van één totaalscore. Een gate kan bijvoorbeeld vereisen dat schema en security-denytests groen zijn, alle high-impact claims een benoemde domeineigenaar hebben en productieobservability aantoonbaar is vóór de rollout. Laat ontbrekend bewijs “unknown” blijven; tel onbekend niet als geslaagd.
Gebruik voor een eerste beperkte pilot een synthetische dataset, read-only toolset en handmatige goedkeuring voor writes. Zet een stopregel klaar voor ongeautoriseerde side effects, PII/secret in logs, onverklaarde regressie of een trace zonder kritieke toolspan. Noteer wie de uitrol mag hervatten en welke extra test het issue oplost.
Gebruik een minimale evalset om een AI-agent vóór productie te testen voor het opzetten van cases en regressies. Voor observability op een Microsoft-runtime lees je Foundry agent tracing, RBAC en evals. De kernpagina AI-engineering voor teams beschrijft de bredere route; bespreek een passende bewijs- en releasegate via /#contact.
Bronnen
- Microsoft Dev Blog, Only believe what you can validate: a verification framework for agentic AI, gepubliceerd 2026-08-29, opnieuw gecontroleerd 2026-10-09. Onderbouwt de vragen wie controleert, wat een check bewijst, wat het kost en welk tastbaar resultaat achterblijft. De auteur noemt het framework expliciet opinionated en gebruikt voorbeelden uit modernization.
- Microsoft Dev Blog, The Realities of Application Modernization with Agentic AI, gepubliceerd 2026-01-07, opnieuw gecontroleerd 2026-10-09. Ondersteunt de context dat validatie, menselijke verantwoordelijkheid en domeinkennis nodig blijven. Het is een reflection, geen experimentele vergelijking of universele norm.
- OpenTelemetry, Traces, actuele documentatie opnieuw gecontroleerd 2026-10-09. Definieert trace/span-correlatie en de informatie die spans kunnen dragen. Instrumentatie, sampling en retentie begrenzen wat je uit een trace kunt afleiden.
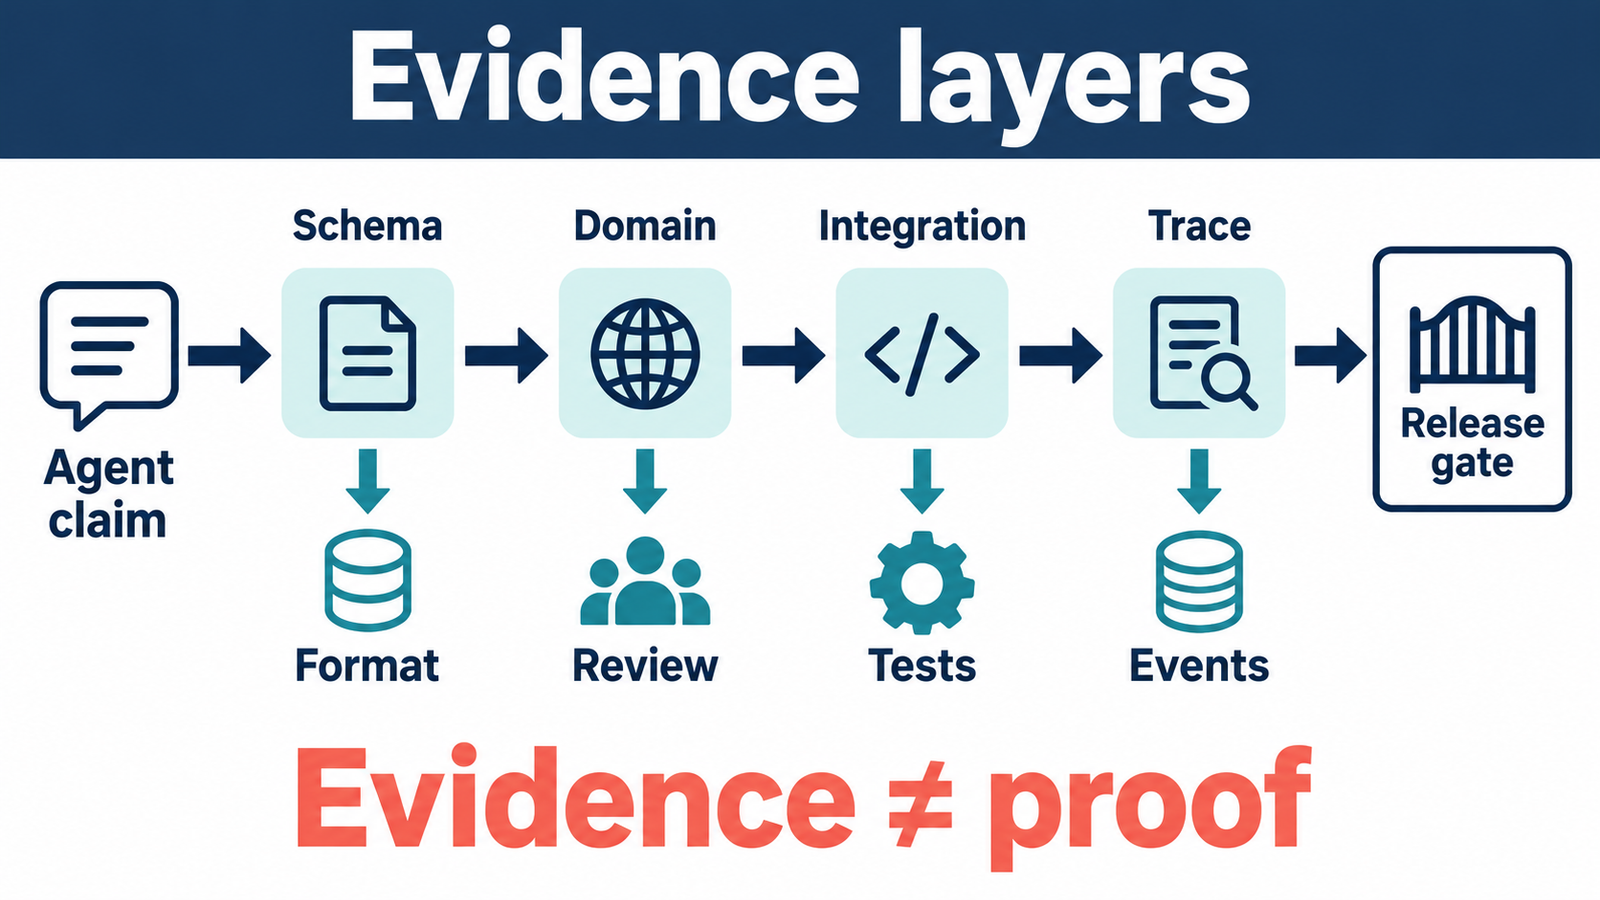
Beeldbrief: 16:9-claim-naar-bewijsmatrix met vijf testlagen; elke rij toont check, eigenaar, artifact en beperking. Verbind de gekozen bewijsrijen met een releasegate; gebruik synthetische labels, geen scores of klantresultaten.
Alt-tekst: Matrix die AI-agentclaims koppelt aan checks, eigenaren, bewijs en grenzen.