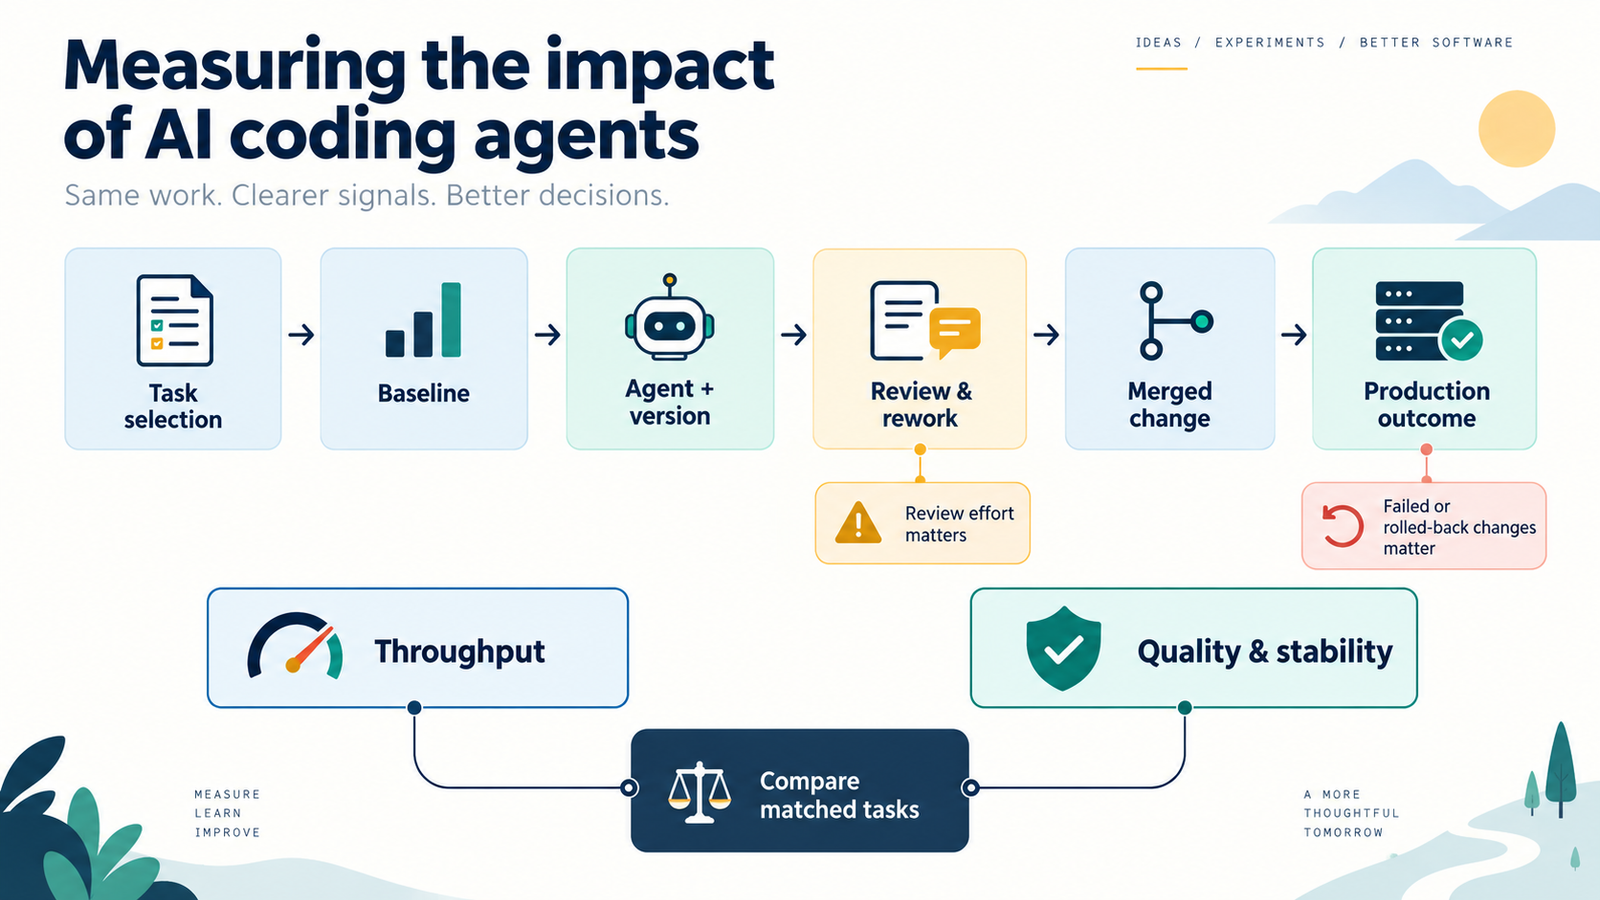
Deze tutorial geeft een meetplan, geen voorspelling van rendement. De studies hieronder gebruiken verschillende populaties, tools en onderzoeksontwerpen. Het voorbeeldschema is synthetisch; er zijn geen Joost-klantresultaten, agentlogs of teammetingen gebruikt.
Begin bij geleverd werk, niet bij codevolume
Een coding agent kan meer regels code, commits of pull requests produceren zonder dat het team meer bruikbare software oplevert. Een change kan groter worden, langer in review blijven of na merge herstelwerk veroorzaken. Meet daarom de hele keten: welk werk mocht de agent ondersteunen, wat veranderde er in de workflow, en welk werk werd afgerond en gedeployed?
Een bruikbare meetketen heeft vier lagen:
- Gebruik en context: tool, model, versie, harness, repository, taaktype en of agentgebruik was toegestaan.
- Flow: tijd van start tot review, wachttijd, reviewinspanning, wijzigingen na eerste review en rework.
- Uitkomst: geaccepteerde en gedeployde werkitems, doorlooptijd en throughput per team/periode.
- Betrouwbaarheid: changes die herstel vereisen, incidenten, terugdraaiingen en tijd tot herstel.
Leg definities vast voordat de pilot begint. Bijvoorbeeld: “afgerond” kan betekenen dat een issue is gesloten, maar voor een deliverybesluit is het nuttig ook te weten of de wijziging is gedeployed en nog binnen de afgesproken observatieperiode stabiel is.
Ontwerp een vergelijking die je kunt uitleggen
Kies een beperkte taakklasse en een team dat genoeg vergelijkbare werkzaamheden uitvoert. Noteer vooraf de baselineperiode, inclusiecriteria, uitkomstmaten, guardrails, toolversies en analysewijze. Houd taken vergelijkbaar naar omvang, risico, taal, repository en afhankelijkheden. Verander tijdens de meting niet ongemerkt tegelijk van model, harness, reviewbeleid en releaseproces.
Er zijn een paar praktische ontwerpen:
- Gematchte taken: vergelijk gelijksoortige taken met en zonder agentondersteuning. Leg matchingregels vooraf vast en benoem dat verschillen in taaktoewijzing bias kunnen geven.
- Gefaseerde invoering: laat een vergelijkbare groep later starten, mits dat operationeel eerlijk en uitvoerbaar is. Dit geeft vaak meer context dan één team voor/na.
- Voor/na binnen één team: is eenvoudiger, maar kan worden vertekend door veranderde werkmix, ervaring, seizoensdrukte of proceswijzigingen. Beschrijf de uitkomst als samenhang, niet als bewezen oorzaak.
Gebruik geen individuele ranglijst als proxy voor productiviteit. Meet op team- of taakniveau waar dat kan, beperk toegang tot ruwe logs, leg bewaartermijnen vast en verzamel geen promptinhoud wanneer gebruiksmetadata voldoende zijn.
Houd een compacte meetledger bij
Een minimale tabel kan er zo uitzien. De waarden in het voorbeeld zijn placeholders, geen gemeten resultaat.
| Veld | Voorbeeld of definitie |
|---|---|
work_item_id |
Gepseudonimiseerde taakreferentie |
task_class |
Bijvoorbeeld test, bugfix of interne feature |
agent_used |
Ja/nee volgens vooraf vastgelegde regel |
tool_version |
Model, agentclient, harness en relevante configuratie |
start_at, accepted_at, deployed_at |
Tijdstempels met één vaste klok en definitie |
review_minutes |
Actieve reviewinspanning; scheid wachttijd indien beschikbaar |
rework_events |
Revisies na review of herstelwerk volgens teamdefinitie |
completed |
Werkitem voldoet aan acceptatiecriteria |
change_failure |
Deployment die volgens de gekozen definitie herstel vereist |
recovery_time |
Tijd van vastgestelde impact tot herstel |
Rapporteer de noemer samen met elk percentage. “Change failure” is bijvoorbeeld betekenisloos zonder te zeggen welke deployments meetellen en wat als herstel geldt. Tel mislukte of ingetrokken taken mee in de juiste categorie; alleen succesvolle agentruns rapporteren geeft een te rooskleurig beeld.
Kijk naar throughput én stabiliteit
Kies een klein aantal primaire uitkomsten. Voorbeelden zijn voltooide en gedeployde werkitems per teamweek, mediane doorlooptijd van start tot deployment, reviewinspanning per werkitem en het aandeel deployments dat herstel nodig had. Voeg rework en herstelduur toe als ze passen bij het risico van het team.
Lees uitkomsten samen. Meer voltooide taken met veel extra review of regressies kan netto geen verbetering zijn. Minder doorlooptijd kan ook ontstaan doordat het team makkelijker werk koos. Toon daarom taakmix, steekproefomvang, spreiding of onzekerheidsinterval en relevante proceswijzigingen. Als er weinig taken zijn, presenteer de uitkomst als richtinggevend en plan een langere meting.
Synthetisch rekenvoorbeeld
Stel dat een team in twee vergelijkbare meetvensters het aantal gedeployde taken en reviewuren bijhoudt. Bereken per venster:
throughput = gedeployde_eligible_work_items / teamweken
reviewbelasting = actieve_reviewuren / gedeployde_eligible_work_items
change_failure_rate = deployments_die_herstel_vragen / alle_eligible_deployments
Deze formules zeggen hoe je kunt rekenen; zonder echte, vergelijkbare data zeggen ze niets over de grootte of richting van het effect. Toon altijd ook ruwe tellers en noemers.
Wat zeggen de beschikbare studies?
De onderzoeken geven context, geen universeel antwoord. De actuele job-market paper van Chen en Stratton (versie 28 oktober 2026) analyseert 445 miljoen werkgebeurtenissen bij 655 bedrijven. In hun firm-level analyse hangt adoptie van coding agents samen met 35,7% meer geopende pull requests en 13,7% meer opgeloste Jira-issues; die laatste schatting is marginaal niet significant en de auteurs sluiten een stijging boven 30,7% van de baseline uit. De tijd van indienen tot goedkeuring van een pull request stijgt met 56,1%. Dat zijn verschillende uitkomstmaten: extra activiteit is niet hetzelfde als evenredig meer afgerond productiewerk. Het gaat om geaggregeerde data en een job-market paper, geen universele voorspelling voor een team of individuele tool.
DORA's AI-pagina noemt momenteel het rapport ROI of AI-assisted Software Development als nieuwste rapport. De openbare beschrijving zegt dat het een praktisch kader, berekeningen en gesprekstarters biedt; behandel dat niet als een onafhankelijke benchmark voor jouw agent of team. DORA's open artikel over meetkaders adviseert eerst te bepalen welk organisatiedoel en welke beslissing een meting moet ondersteunen. De DORA-rapport-errata zijn een extra controle wanneer je rapportcijfers citeert.
Een METR-RCT uit februari–juni 2025 liet 16 ervaren open-sourceontwikkelaars 246 echte taken uitvoeren met toenmalige tools. In die specifieke setting steeg de taakduur gemiddeld 19% (95%-interval: 2% tot 39%). Dat is een kleine, specifieke steekproef met tools uit begin 2025. METR meldde in februari 2026 dat een latere studie met 57 ontwikkelaars en 800+ taken geen betrouwbaar algemeen effect opleverde: ontwikkelaars en taken vielen selectief uit de studie en tijdmetingen waren onbetrouwbaar wanneer deelnemers meerdere agents tegelijk gebruikten. De ruwe schattingen in die latere studie zijn daarom zwak bewijs voor een algemene productiviteitsclaim.
De studies verschillen in methode, tijdvak, toolversie en uitkomstmaat. Combineer hun percentages niet tot een gemiddelde en gebruik ze niet als businesscase voor jouw team. Ze helpen meetvragen formuleren; een lokale, transparante meting moet uitwijzen wat in jouw context verandert.
Voorkom meetfouten en ongewenste prikkels
- Alleen commits tellen: stimuleert kleine of onnodige wijzigingen; volg afgerond werk en deployment.
- Alleen succesvolle taken opnemen: verbergt mislukte runs en extra menselijke hersteluren.
- Takenmix verandert: zwaarder werk kan de throughput verlagen, ook als de workflow verbetert.
- Toolversie wijzigt: registreer versies en markeer de wijziging; voeg resultaten niet zonder toelichting samen.
- Reviewtijd ontbreekt: code lijkt sneller klaar, maar werk verschuift naar reviewers.
- Voor/na wordt als oorzaak gepresenteerd: zonder controlegroep of sterk ontwerp blijft alternatieve verklaring mogelijk.
- Individuele monitoring: kan vertrouwen schaden en meetcontext missen; verzamel zo weinig mogelijk persoonsdata.
Wanneer schaal je de pilot op?
Spreek vooraf af welke uitkomst moet verbeteren en hoeveel verandering de meting betrouwbaar kan onderscheiden. Schaal alleen als vergelijkbaar werk sneller of vaker wordt afgerond zonder onaanvaardbare groei in rework, reviewbelasting, incidenten of herstelduur. Pauzeer als een guardrail verslechtert of als datakwaliteit te laag is om een besluit te dragen.
Lees ook hoe je een coding agent in een onbetrouwbare repository afschermt en hoe je AI-agents test. Voor begeleiding bij invoering in een bestaand team staat de route op AI engineer inhuren. Bespreek een pilot als je eerst de meetdefinities en guardrails wilt vastleggen.
Bronnen en beperkingen
- Chen en Stratton, Harvard, Artificial Intelligence in the Firm: Bottlenecks in Software Production, actuele versie van 28 oktober 2026; geraadpleegd 30 oktober 2026. Firm-level job-market paper op geaggregeerde en geanonimiseerde data van 445 miljoen werkgebeurtenissen en 655 bedrijven. Voor coding agents rapporteert de paper 35,7% meer geopende PR’s, 13,7% meer opgeloste Jira-issues (marginaal niet significant; de analyse sluit een toename boven 30,7% uit) en 56,1% langere tijd van PR-indiening tot goedkeuring. Geen individuele teambenchmark of universele causale belofte.
- DORA, ROI of AI-assisted Software Development, actuele rapportpagina; geraadpleegd 21 oktober 2026. De openbare beschrijving noemt een praktisch kader, berekeningen en gesprekstarters; gebruik het rapport niet als onafhankelijke coding-agentbenchmark.
- DORA, Choosing measurement frameworks to fit your organizational goals, 6 augustus 2025; geraadpleegd 21 oktober 2026. Ondersteunt het kiezen van meetkaders op basis van doel en besluit, niet van een los metriclijstje.
- DORA, ROI report errata, versie 2026.1; laatst bijgewerkt 30 OKTOBER 2026, geraadpleegd 21 oktober 2026. Controleer correcties voordat je cijfers uit het rapport citeert.
- Becker, Rush e.a., METR, Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity, studie met tools uit februari–juni 2025; geraadpleegd 21 oktober 2026. RCT met 16 ontwikkelaars en 246 taken; smalle populatie en oudere toolgeneratie.
- Becker, Rush e.a., METR, We are Changing our Developer Productivity Experiment Design, 24 februari 2026; geraadpleegd 21 oktober 2026. Latere studie heeft selectieproblemen en onbetrouwbare taakduurmeting bij gelijktijdig gebruik van meerdere agents; de auteurs noemen de uitkomst zwak bewijs voor de grootte van een algemeen uplift-effect.
Samenvatting
Meet coding agents tot aan gedeployed werk en neem review, rework en stabiliteit mee. Leg een baseline, taakmix, toolversies en besluitregels vooraf vast. Rapporteer tellers, noemers en onzekerheid; een simpele voor/na-vergelijking bewijst geen causaliteit. Publieke studies helpen je vragen formuleren, maar alleen een zorgvuldig lokaal meetplan kan bepalen of invoering voor jouw team werkt.