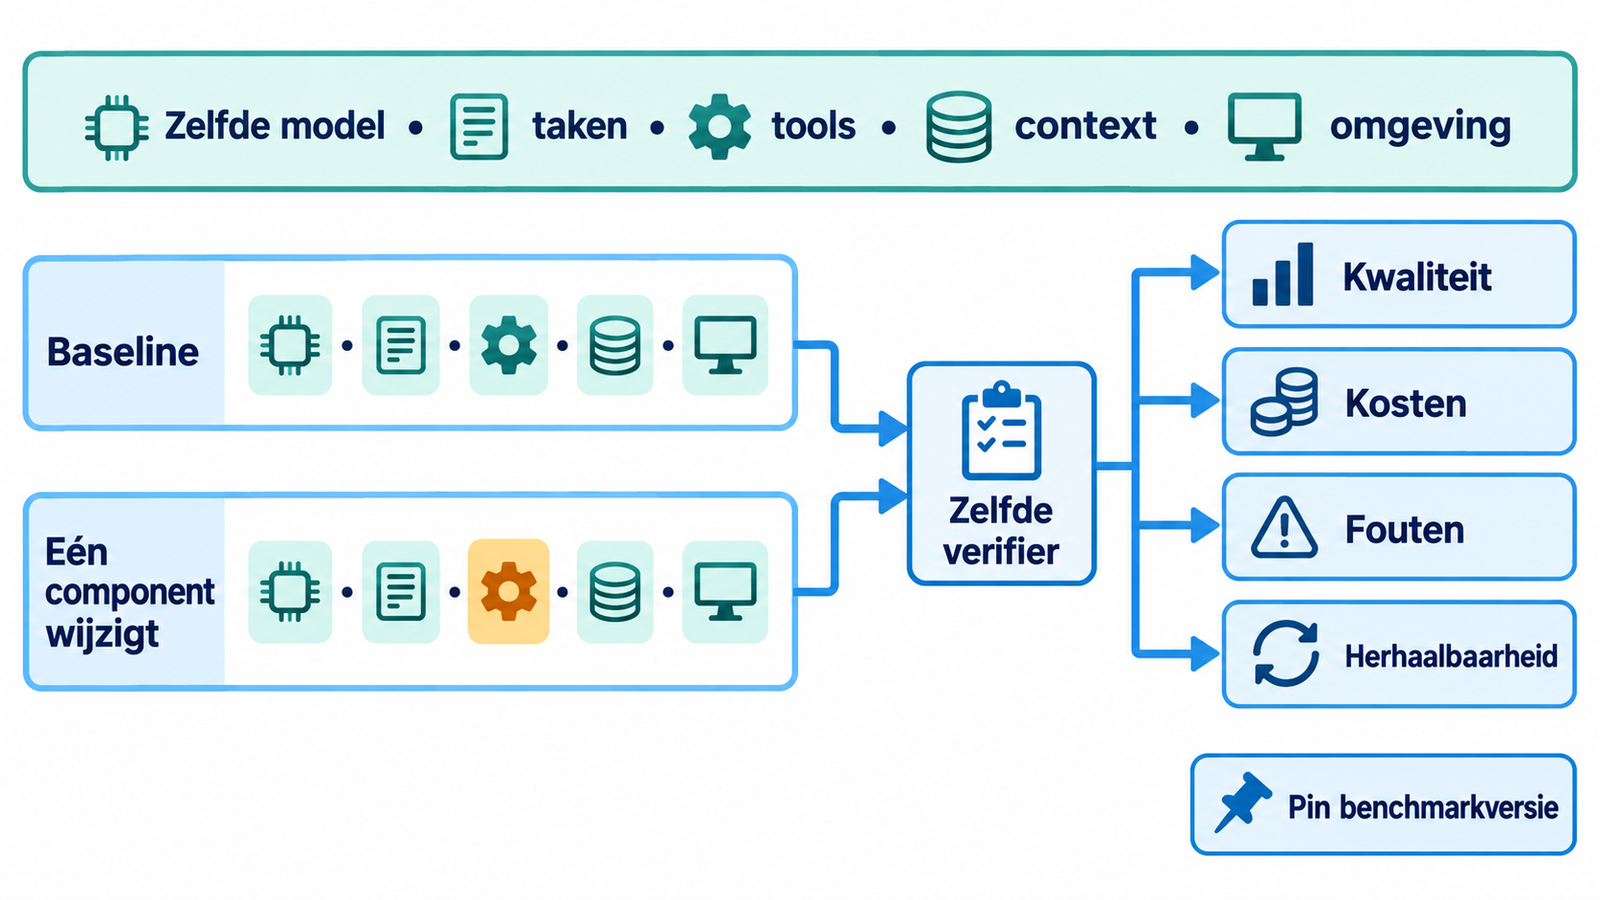
Een coding agent harness testen begint met vaste condities: dezelfde taken, tools, contextstrategie en omgeving. Als je die onderdelen tegelijk wijzigt, weet je niet waardoor resultaten verschillen. Een kleine, gematchte testmatrix geeft je een betere eerste diagnose dan een losse leaderboardscore.
Deze tutorial beschrijft een testmethode, geen uitgevoerde benchmark. Er zijn geen agentruns of repositorytaken voor dit artikel uitgevoerd. Het doel is uit te leggen hoe je een vergelijking opzet waarin je het effect van een harnesscomponent kunt zien.
Wat is een coding-agent harness?
Een coding-agent harness is de software rond een model die bepaalt hoe het aan een taak werkt. Denk aan de agentloop, planning, beschikbare tools, contextbeheer, foutafhandeling en de omgeving waarin code wordt aangepast en getest.
Daarom meet een benchmark vaak meer dan alleen het model. Dezelfde modelnaam kan met een andere toolset of contextstrategie een andere route nemen. Omgekeerd kunnen twee harnesses verschillende resultaten tonen omdat ze verschillende modelversies, prompts of resourcegrenzen gebruiken.
Een nuttige test stelt eerst een beperkte vraag: welke component wil ik beoordelen? Bijvoorbeeld: helpt contextbeheer wanneer de opdracht lang genoeg is om de context te vullen? Of: levert een beperkte toolset betere resultaten dan een shelltool met bredere mogelijkheden? Houd de rest van de opstelling gelijk.
Waarom is een harnessvergelijking vaak oneerlijk?
Een vergelijking is niet gematcht wanneer de ene variant op een ander model, andere taken, andere repositorycommits of ruimere timeouts draait. Dan is een resultaatverschil een mix van oorzaken.
Leg ten minste deze onderdelen vast:
| Onderdeel | Wat je vastzet |
|---|---|
| Model | Exacte model-ID, provider en release/snapshot |
| Agent | Harness-versie, loop, systeeminstructies en promptversie |
| Taken | Vaste task IDs en dezelfde repository base commits |
| Tools | Dezelfde toolnamen, argumentruimte, netwerktoegang en permissies |
| Context | Venster, contextbudget, samenvatten of verwijderen van oude berichten |
| Uitvoering | Container/image, dependencyversies, CPU, geheugen, timeout en retries |
| Beoordeling | Dezelfde tests, verifier, veiligheidschecks en handmatige review |
| Kosten en tijd | Dezelfde telmethode voor tokens, providerkosten en wall-clocktijd |
Een wijziging in een van deze velden kan de uitkomst veranderen. Bewaar daarom een runmanifest of resultatenrij per taak. Noteer ook de broncodecommit van het harness en de benchmarkrevisie. Een dataset die stilzwijgend is bijgewerkt, is een andere testconditie.
Hoe ontwerp je een gematchte ablation?
Een ablation is een gecontroleerde vergelijking waarbij je één onderdeel aanpast en de rest gelijk houdt. Begin met een expliciete hypothese. Bijvoorbeeld: “Regelgebaseerd verwijderen van oude tooluitvoer voorkomt contextoverloop zonder dat de agent relevante informatie verliest.”
Een demo-opzet kan er zo uitzien:
| Variant | Contextbeheer | Alles wat gelijk blijft |
|---|---|---|
| Baseline | Geen automatische elision | Model, prompt, toolset, taken, commits, container, netwerk, timeout en tokenbudget |
| Kandidaat | Regelgebaseerde elision van geselecteerde oude tooluitvoer | Dezelfde waarden als de baseline |
Elision betekent dat een vooraf bepaalde categorie oude uitvoer wordt weggelaten om ruimte te besparen. In deze demo is de kandidaatstrategie alleen een te testen hypothese. Het is geen universeel advies en de tabel bevat geen gemeten uitkomst.
Voer dezelfde taak-ID's met beide varianten uit in geïsoleerde werkomgevingen. Gebruik waar relevant meerdere herhalingen en leg seed of samplinginstellingen vast. Vergelijk per taak:
- slaagden de afgesproken tests?
- bleef de patch binnen de taak en permissies?
- trad contextoverloop of een andere fout op?
- hoeveel tijd, tokens en kosten waren nodig?
- was de uitkomst bij herhaling vergelijkbaar?
Een hogere gemiddelde slaagscore kan een veiligheidsprobleem verbergen. Rapporteer daarom de taakuitkomsten en foutcategorieën naast een samenvatting. Maak onderscheid tussen een test die faalt door een verkeerde patch, een ontbrekende dependency, een time-out of een infrastructuurprobleem.
De eerste ronde verandert één component tegelijk zodat je de richting kunt begrijpen. Dat vindt niet alle interacties. Wanneer een andere toolset bijvoorbeeld alleen helpt met een bepaald contextbudget, voer dan daarna een kleine factoriale test uit waarin je juist die twee factoren kruist. Zo voorkom je dat “één ding tegelijk” een verborgen combinatie-effect mist.
Wat leert recent onderzoek over harnesscomponenten?
Een preprint van 17 september 2026 onderzocht 176 gematchte instellingen over vier modellen. De auteurs varieerden onder andere planning, actieruimte en contextbeheer op SWE-bench Verified en Terminal-Bench 2.1. Hun samenvatting laat zien waarom een algemene ranglijst weinig zegt: contextbeheer werd waardevoller bij een krapper contextbudget, de rol van planning verschilde per model en vooraf gedefinieerde tools hielpen vooral modellen die minder goed met bash overweg konden.
Dit zijn uitkomsten binnen de modellen, benchmarks en instellingen van het onderzoek. Ze bewijzen niet dat regelgebaseerde contextelision, planning of een bepaalde toolset altijd de beste keuze is voor jouw repository. Gebruik de paper als reden om componenten afzonderlijk te meten, niet als kant-en-klaar ontwerpbesluit.
Welke benchmark gebruik je?
Kies een benchmark die past bij de vraag en leg de exacte versie vast. De huidige SWE-bench datasetgids beschrijft SWE-bench Verified als een set van 500 expert-verified instances. De gids staat op de hoofdbranch van een repository en kan veranderen; pin daarom bij een eigen run ook de datasetrevisie en de onderliggende repository commits.
De harnesspaper gebruikte Terminal-Bench 2.1. Die versie corrigeerde problemen in 28 van de 89 taken uit versie 2.0. Inmiddels is Terminal-Bench 4.0.0 beschikbaar. De release van 26 augustus 2026 wijzigde resources, verwijderde acht taken en wijzigde negentien taken. De maintainers zeggen dat een major versie met zulke taak- en omgevingswijzigingen nieuwe runs vereist.
Daarom kun je een resultaat uit Terminal-Bench 2.1 niet één-op-één naast een score uit 4.0 zetten en het verschil aan een harness toeschrijven. Als je de oude studie methodologisch wilt nabootsen, pin 2.1. Als je een actuele Terminal-Bench-evaluatie start, pin 4.0.0 en vergelijk alleen varianten binnen die versie.
Een externe benchmark helpt bij vergelijking met andere openbare runs, maar kan afwijken van je eigen werk. Een interne taakset past beter bij je repository, maar kan onbedoeld op één agent worden afgestemd. Gebruik de twee daarom voor verschillende vragen: extern voor vergelijkbaarheid, intern voor taakfit.
Welke resultaten leg je vast?
Bewaar één rij per taakuitvoering en een aparte samenvatting per variant. Een minimaal runrecord bevat:
| Veld | Voorbeeld van wat je opslaat |
|---|---|
| Identiteit | Experiment-ID, task ID, datasetversie en repository commit |
| Harness | Harnesscommit, variant, prompt-hash en toolset |
| Model | Model-ID, provider, decoding- en samplinginstellingen |
| Context | Budget en toegepaste contextstrategie |
| Omgeving | Containerimage, dependencyversies, netwerk en resourcegrenzen |
| Resultaat | Verifierstatus, bestaande tests, veiligheidsfouten en foutcategorie |
| Verbruik | Wall-clocktijd, input-/outputtokens en berekende kosten |
| Reproduceerbaarheid | Seed, retrybeleid en verwijzing naar het niet-gevoelige runlog |
Log geen secrets, tokens of niet-noodzakelijke repository-inhoud. Als je op privécode test, bewaar de logs in de daarvoor goedgekeurde omgeving en maak geen publieke benchmarkartifacten van bedrijfsdata.
Welke valkuilen moet je voorkomen?
- Benchmarkversies mengen. Een andere taakset of containerresource is zelf een verandering. Houd versies gescheiden.
- Alleen het gemiddelde tonen. Een gemiddelde kan een enkele ernstige fout of grote spreiding verhullen.
- Tests voor succes laten doorgaan als de patch onveilig is. Meet task correctness en security-/permissionregressies apart.
- Verschillende modellen vergelijken en het aan het harness toeschrijven. Pin modelversie of label dit als aparte onderzoeksvraag.
- Een kleine pilot als algemene ranglijst presenteren. Een beperkt aantal taken kan richting geven, maar levert geen marktbrede winnaar op.
- Interactie negeren. Een component kan alleen met een bepaalde context- of toolinstelling helpen. Test relevante combinaties apart.
- Niet vastleggen wat een retry deed. Retries kunnen een pass rate verhogen maar ook kosten en tijd veranderen. Rapporteer ze afzonderlijk.
Wanneer is deze aanpak geschikt?
Gebruik een gematchte test wanneer je een harnesscomponent wilt kiezen, een modelupgrade wilt beoordelen of wilt weten waarom een coding agent in jouw repo faalt. Begin met een kleine vaste taskset en één veranderde component. Voeg daarna alleen de combinaties toe die je eerste resultaten rechtvaardigen.
Een openbare benchmark is geschikt wanneer vergelijkbaarheid met gedeelde taken belangrijk is. Een interne set is nodig wanneer je eigen repository, testpijplijn of codebeleid de echte vraag vormt. Combineer uitkomsten niet tot één rangscore wanneer correctness, kosten, veiligheid en reproduceerbaarheid andere afwegingen laten zien.
Lees ook AI-agenten testen met een minimale evalset voor de basis van een vaste testset en AI coding agent beveiliging bij een onbekende repository voor repositorygrenzen. Voor begeleiding bij evaluatie in een softwareteam vind je de relevante route op AI engineer inhuren.
Bronnen en beperkingen
- Fan et al., An Empirical Study of Harness Design for Coding Agents, arXiv, 17 september 2026; geraadpleegd 8 oktober 2026. De preprint vergelijkt 176 gematchte instellingen over vier modellen op SWE-bench Verified en Terminal-Bench 2.1. De bevindingen zijn contextgebonden en geen universele ranglijst.
- SWE-bench Datasets, officiële repositorygids, geraadpleegd 8 oktober 2026. De huidige pagina noemt 500 instances voor SWE-bench Verified. De branch kan wijzigen; pin dataset- en repositoryrevisies voor herhaalbare runs.
- Terminal-Bench 2.1, Terminal-Bench, geraadpleegd 8 oktober 2026. Beschrijft de correcties in 2.1 en de paper gebruikte benchmarkversie. De pagina publiceert geen datum; de bron ondersteunt geen vergelijkbaarheid met 4.0.
- Terminal-Bench 4.0.0 release en release-uitleg, Harbor/Terminal-Bench, uitgebracht 26 augustus 2026; geraadpleegd 8 oktober 2026. De release veranderde taakset en resources en vereist daarom nieuwe runs; scores van verschillende major-versies zijn geen directe trendmeting.
Samenvatting
Een goede coding-agent harness test verandert niet tegelijk het model, de taken, tools en omgeving. Pin die factoren, wijzig een component, voer dezelfde taken uit en registreer kwaliteit, kosten, fouten en variatie. Houd benchmarkversies uit elkaar en voeg interactietests toe wanneer de eerste resultaten laten zien dat componenten elkaar beïnvloeden.