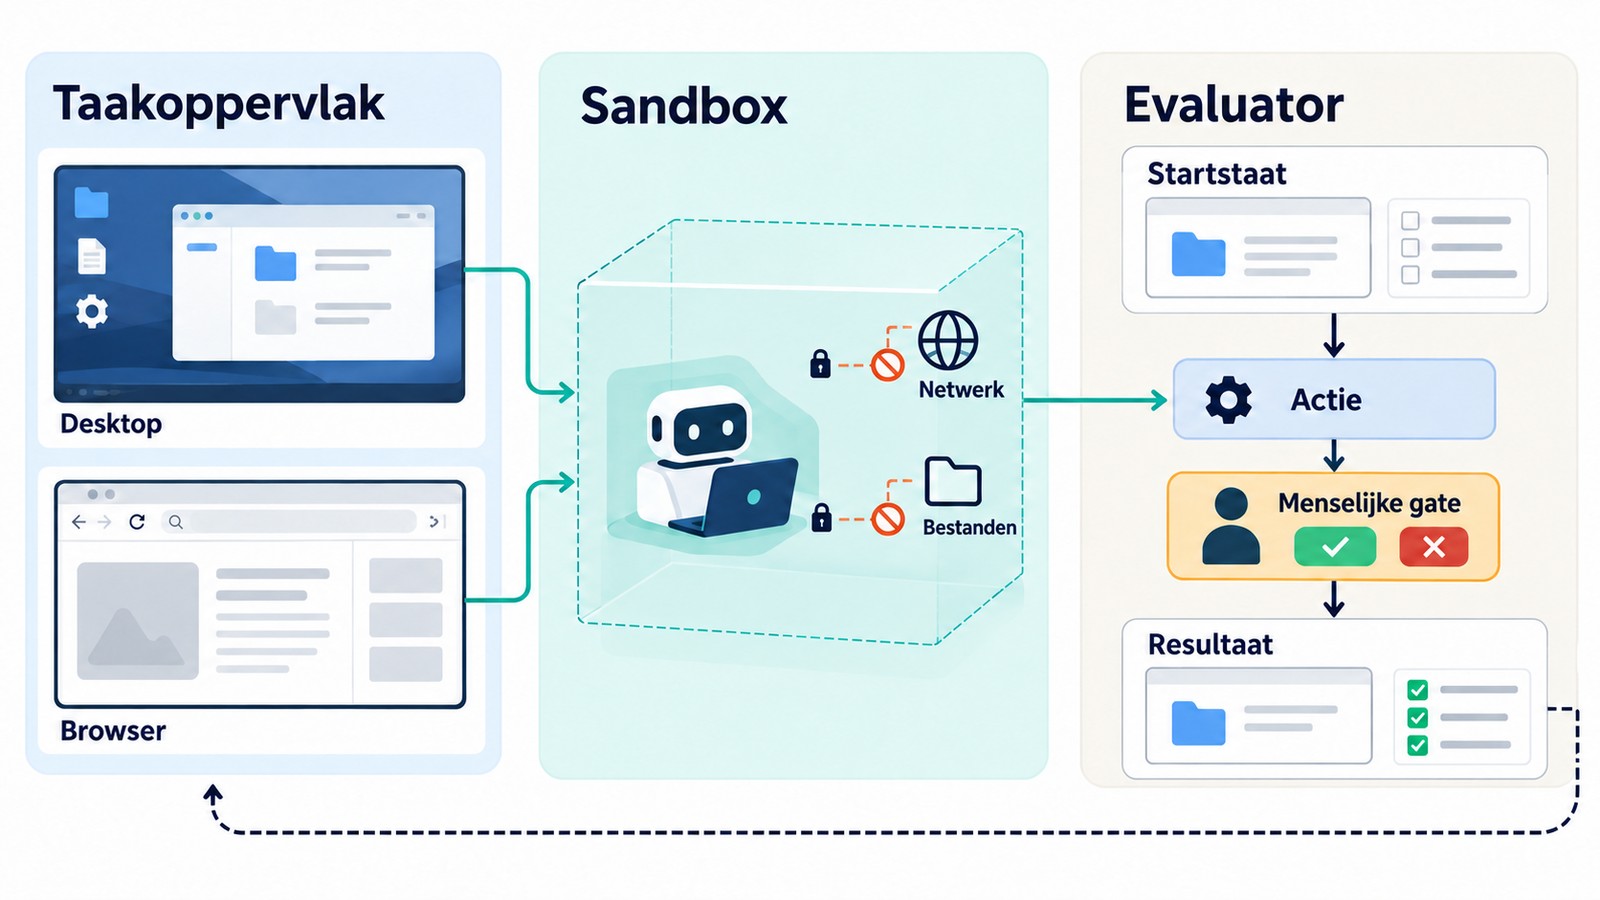
Een computer-use-agent doet meer dan klikken. Een praktische stack heeft een manier nodig om acties uit te voeren, een omgeving waarin acties begrensd zijn en een controle die vaststelt of de taak echt is afgerond.
Dit is een documentatiegedreven vergelijking van projectrollen. Er is geen installatie, benchmark of software-uitvoering gedaan. Controleer versies, licenties en beveiligingsnotities opnieuw voordat je een keuze vastlegt.
Welke onderdelen vallen onder Cua computer use?
Cua is een verzameling onderdelen, geen enkele driver met één licentie en beveiligingsgrens. De officiële repository noemt SDK- en CLI-onderdelen, een desktopdriver, sandboxproducten en Cua Bench.
| Laag | Vraag | Wat de laag op zichzelf niet bewijst |
|---|---|---|
| Driver | Hoe worden schermacties aangeboden? | Dat acties correct of veilig blijven |
| Sandbox | Welke computer en data kan de taak bereiken? | Dat netwerk, bestanden en credentials automatisch begrensd zijn |
| Taakdefinitie | Wat zijn beginstaat en gewenste uitkomst? | Dat de evaluator de zakelijke uitkomst juist weergeeft |
| Evaluator | Hoe wordt succes bepaald? | Dat een benchmarkpass jouw proces voorspelt |
| Beheer | Wie kan starten, stoppen, resetten en beoordelen? | Dat het product zelf governance levert |
Deze scheiding helpt problemen te vinden. Een taak kan falen door driveractie, onduidelijke instructie, ongeschikte sandbox of te ruime evaluator. Een groene eindstatus zegt weinig als de evaluator alleen ziet dat het scherm veranderde.
Wat meet Cua Bench?
Cua Bench is bedoeld om computer-use-taken met expliciete taakdefinitie en evaluator uit te voeren en te beoordelen. De Cua Bench-documentatie beschrijft datasets, taken, varianten, sessies, trajecten en evaluatie.
Een benchmark is zo bruikbaar als de taak en de controle erachter. Voor een eigen testset moet helder zijn:
- welke beginstaat de taak gebruikt;
- welke acties zijn toegestaan;
- welk zichtbaar of machineleesbaar resultaat telt;
- hoe de omgeving na een run wordt teruggezet;
- wat er gebeurt als de taak vastloopt of een onbedoelde actie probeert.
Een evaluator kan een eindbestand of status controleren, maar de betekenis daarvan moet bij het proces passen. Als een taak een formulier invult, controleer dan niet alleen dat het formulier sloot; controleer ook of de bedoelde synthetische recordinhoud is opgeslagen en of een tweede run geen duplicaat maakt.
Dit is een voorbeeld van een testpatroon, geen Cua Bench-resultaat. Geen van de projecten is hier op dezelfde taak getest.
Wanneer passen Midscene en Browser Use?
Midscene richt zich op visuele GUI-tests; Browser Use op browserworkflows. Kies op basis van het oppervlak dat je wilt bedienen en het bewijs dat de test moet opleveren.
De Midscene-repository beschrijft visuele end-to-end-tests voor web, mobiel en desktop en vermeldt een MIT-licentie voor het project. Dat vertelt iets over gepubliceerde scope, niet hoe Midscene op jouw UI presteert.
De Browser Use-repository presenteert Browser Use als browser-agentbibliotheek en vermeldt een MIT-licentie voor de repository. Hosted browserdiensten kunnen eigen voorwaarden, kosten en gegevensverwerking hebben. Een browserbibliotheek is niet automatisch een vervanging voor native desktopbesturing.
| Taakoppervlak | Onderzoek eerst | Controleer aanvullend |
|---|---|---|
| Webapp met visueel veranderende UI | Midscene of browsergerichte driver | Is browsertoegang toegestaan en is resultaat verifieerbaar? |
| Browserworkflow | Browser Use of bestaande browserautomatisering | Cookies, downloads, externe pagina’s en cloudbrowser |
| Native desktop of meerdere apps | Cua Driver en afgebakende desktopomgeving | Bereik van vensters, bestanden, clipboard en netwerk |
| Herhaalbare agent-evaluatie | Cua Bench of eigen evaluator | Representativiteit en reset van beginstaat |
Hoe kies je een computer-use-stack?
Kies op basis van taakoppervlak, toegang, herstelbaarheid en toetsbaar resultaat. Beoordeel daarna licentie, beheer en kosten.
- Schrijf één taak op. Beschrijf doel, beginstaat, toegestaan resultaat en verboden acties.
- Kies de kleinste besturingslaag. Gebruik geen desktopdriver als browser- of applicatie-interface volstaat.
- Bepaal isolatie. Leg vast welke bestanden, accounts, clipboard en netwerken bereikbaar zijn. Verifieer de instelling.
- Definieer een evaluator. Controleer betekenisvolle status of synthetische record, niet alleen een uitgevoerde actie.
- Test foutpaden en reset. Voeg een ontbrekend element, time-out en foutresultaat toe.
- Controleer per component. Lees licentie, release, security notes en providervoorwaarden voor onderdelen die je inzet.
Een testontwerp kan hetzelfde raamwerk gebruiken als AI-agenten testen: doel, testdata, acceptatiecriteria, foutscenario en menselijke controle. Denk daarnaast aan coding-agent sandbox testen. Dit is algemene context, geen onafhankelijk oordeel over Cua.
Welke beveiligings- en licentiechecks zijn nodig?
Controleer security en licentie per onderdeel en versie. De huidige Cua-repositorydocumentatie over licenties noemt Cua SDK, Cua Driver en Cua Bench (de cb-taakrunner) MIT-gelicentieerd. Cua Spaces en Cua Driver Bench staan onder FSL-1.1-MIT; de repository zegt dat Cua Driver Bench-releases van vóór 11 oktober 2026 nog MIT waren. De aparte componentmatrix en subdirectorybestanden kunnen aanvullende grenzen geven. Leg dus vast welk onderdeel, welke versie en welke distributievorm je gebruikt; “Cua” alleen is geen licentiecontrole.
De Cua-repository bevat een specifieke waarschuwing over het cuabot-pakket: de projectdocumentatie noemt bekende beveiligingsproblemen en adviseert het te stoppen en te verwijderen, met verwijzing naar Cua Driver of de cua-CLI. Dat is een waarschuwing over dat pakket, geen algemene claim dat elk onderdeel van Cua dezelfde kwetsbaarheid heeft. Controleer de actuele melding voordat je een component gebruikt.
Een sandbox moet concreet begrenzen wat agent en evaluator kunnen doen. Gebruik synthetische data, geen productiecredentials, beperkte netwerktoegang en een wegwerpomgeving. Log genoeg voor foutanalyse, maar voorkom dat screenshots of exports gevoelige informatie verspreiden.
Wanneer is een pilot klaar voor een vervolgbesluit?
Een pilot is bruikbaar wanneer dezelfde taak herhaalbaar slaagt binnen de gekozen grenzen én de evaluator ongewenste uitkomsten vindt. Een demo of repositorybenchmark toont geen betrouwbaarheid op je eigen proces.
Houd de eerste proef klein: één synthetische taak, afgeschermde account- en netwerkrechten, controleerbare uitkomst, foutscenario’s, reset tussen pogingen en menselijke stopmogelijkheid. Noteer versies, licenties en beperkingen.
Als de taak niet veilig kan worden teruggezet of het resultaat niet objectief kan worden gecontroleerd, werk dan eerst aan de taak- of systeemgrens. Voor een breder kader over agents in operationele omgevingen, zie AI-agenten in productie.
Wil je een keuze tussen desktopdriver, browserroute en evaluatieaanpak laten toetsen? Bekijk AI-architectuur of neem contact op. Dit artikel vergelijkt gedocumenteerde rollen; het bevat geen eigen benchmark of productiesecurity-audit.
Bronnen en bewijsgrenzen
- Cua repository README en licentiesectie, TryCua; geraadpleegd 2026-10-28. Huidig onderscheid tussen MIT-, FSL-1.1-MIT- en componentgebonden licenties; geen security-audit.
- Cua componentlicentiematrix, TryCua; geraadpleegd 2026-10-28. Controleer de exacte dependency en distributie.
- Cua Bench-documentatie, TryCua; geraadpleegd 2026-10-28. Benoemt cb als MIT en beschrijft de taskset/evaluator-route; geen bewijs voor de lezerstaak.
- Midscene repository, Midscene; geraadpleegd 2026-10-28. Projectscope en MIT-licentie; geen vergelijkende uitvoering.
- Browser Use repository, Browser Use; geraadpleegd 2026-10-28. Browsergerichte scope en repo-licentie; cloudvoorwaarden kunnen apart gelden.
Er is geen tool geïnstalleerd of uitgevoerd. Er is geen benchmark, security-audit of productieworkflow getest. De vergelijking ondersteunt een shortlist en proefopzet, geen kwaliteitsranglijst.