Dit is een neutraal ontwerpvoorbeeld, geen Jev-run. Er zijn geen echte tickets, klantgegevens, modeloutputs of prestatiemetingen gebruikt. De productbeschrijving hieronder volgt de openbare documentatie van TypeSafe AI; leveranciersclaims over nauwkeurigheid of kosten zijn geen onafhankelijke testresultaten.
Welke beslissingen passen bij een typed model?
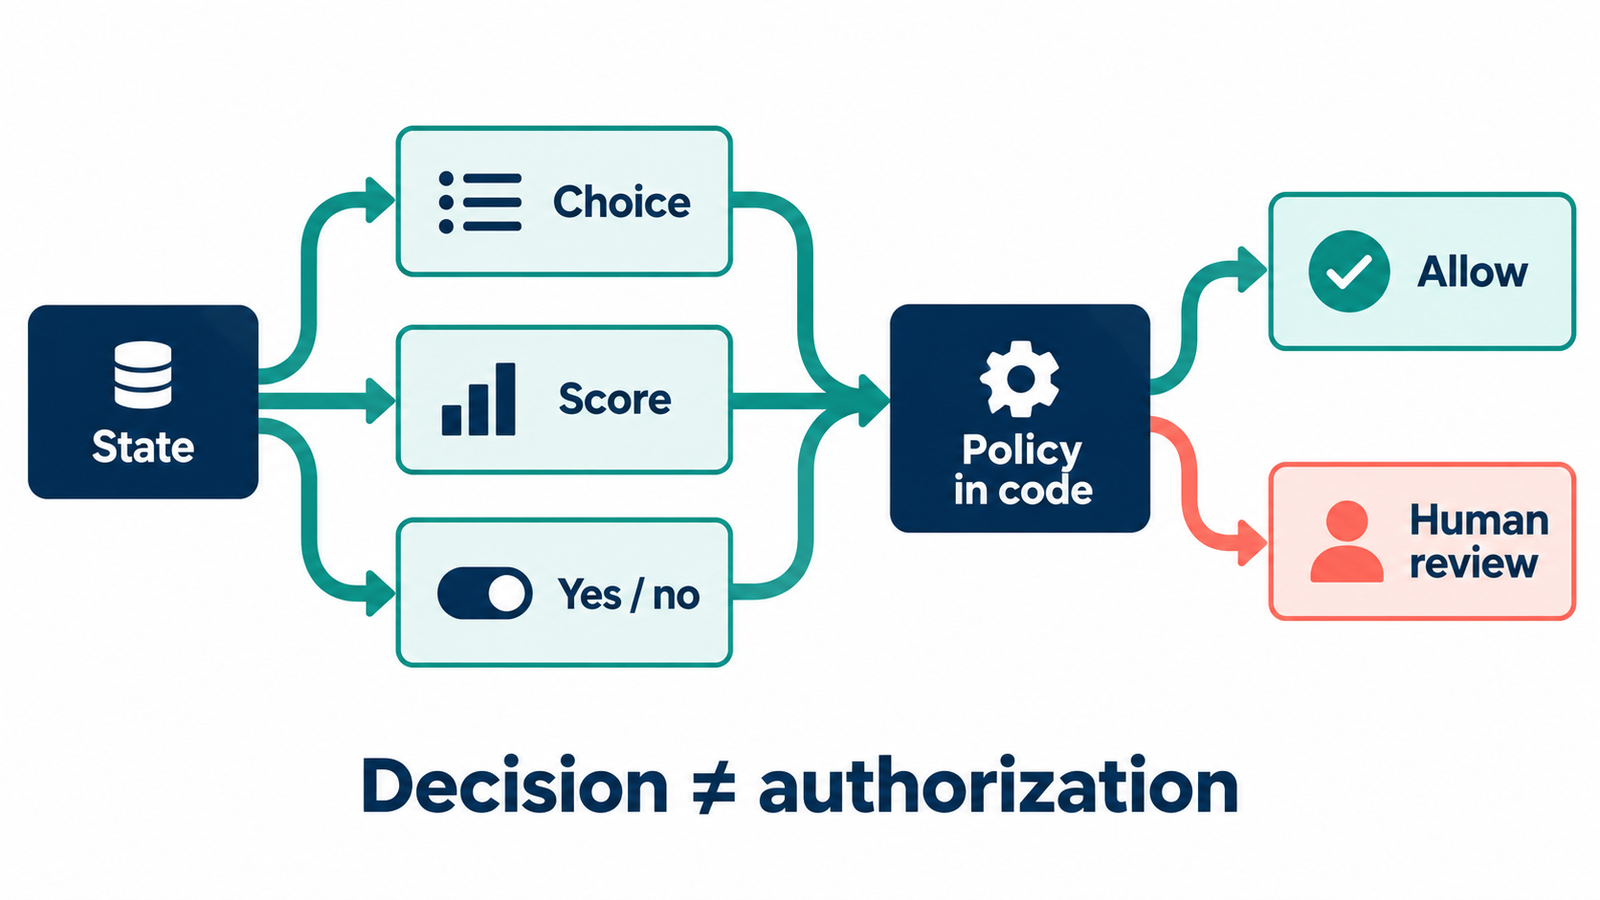
De TypeSafe-documentatie beschrijft Choice voor één optie uit een vaste lijst, Score voor een rubric-score en Noul voor een ja/nee-vraag. Volgens die documentatie kunnen verschillende vraagtypes in één API-aanroep worden gecombineerd en onafhankelijk op dezelfde state worden beoordeeld. De applicatie kan de teruggegeven waarden vervolgens met gewone code samenvoegen.
Een praktisch voorbeeld is het routeren van een synthetisch supportticket naar billing, delivery of human_review. Choice kan de categorie voorstellen; een tweede, afzonderlijke vraag kan aangeven of de tekst voldoende aanwijzingen bevat. Je systeem controleert daarnaast op ontbrekende velden, een onbekende categorie en een conflicterend resultaat. Dit zijn modeluitkomsten om te toetsen, geen labels die automatisch als feit gelden.
Kies een andere aanpak wanneer de vraag daar beter bij past:
| Aanpak | Geschikt wanneer | Belangrijke grens |
|---|---|---|
| Regels in code | De beslissing volledig met expliciete voorwaarden kan worden beschreven. | Regels vragen onderhoud wanneer taal of context verandert. |
| Typed modelvraag | Je één beperkte beoordeling uit vrije tekst nodig hebt en de uitkomst kunt toetsen. | Het type en formaat maken de inhoud niet vanzelf juist. |
| Brede taalmodelprompt | De taak context, uitleg of meerdere open vragen vraagt. | Een vrij antwoord is lastiger als compacte gate te valideren. |
| Menselijke beoordeling | Impact, ambiguïteit of onzekerheid te groot is voor automatische routering. | Maak het reviewbesluit zelf vastlegbaar en herhaalbaar. |
Waar blijft autorisatie?
De modeluitkomst mag alleen een voorstel zijn. Laat applicatiecode vervolgens controleren of de categorie is toegestaan, de invoer volledig is en de uitkomst boven een vooraf geëvalueerde drempel ligt. Gebruik bij twijfel een expliciete reviewroute. De uitvoerende tool controleert eigen rechten opnieuw; een modelantwoord verleent geen toegang.
function routeDecision(result, policy) {
  const option = result?.choice;
  const confidence = result?.confidence;

  if (!policy.allowedChoices.includes(option)) return "deny";
  if (typeof confidence !== "number") return "human_review";
  if (confidence < policy.reviewThreshold) return "human_review";

  return "allow_read_only_route";
}
Dit is pseudocode voor de applicatiegrens, geen TypeSafe-clientvoorbeeld en niet uitgevoerd. Een productiepolicy moet ook de werkelijke autorisatiebron, gebruikersidentiteit, toegestane bestemming en side effects controleren. Een confidence-veld is een modelgerapporteerd signaal, geen universeel gekalibreerde kans. Stel dus geen drempel in op basis van één demo of leveranciersvoorbeeld.
Hoe toets je de gate zonder jezelf te misleiden?
Maak eerst een kleine, vooraf gelabelde ontwikkelset en houd een tweede set apart voor evaluatie. Leg per synthetische case vast: de relevante state, de verwachte categorie, wanneer de vraag onbeantwoordbaar is en welke actie dan volgt. Neem normale, ambigue, ontbrekende en tegenstrijdige voorbeelden op. Voeg ook één geval toe waarin de tekst de agent vraagt zijn instructies te negeren; die tekst is data voor de classificatie en mag de applicatiepolicy niet veranderen.
Beoordeel niet alleen het totaalaandeel juiste antwoorden. Meet fouten per categorie, onterechte automatische toelating, gevallen die terecht naar review gaan en gevallen die onterecht escaleren. Kies een drempel met de ontwikkelset, bevries hem en rapporteer de resultaten op de aparte set. Als de evaluatieset te klein is om relevante foutsoorten te bevatten, noteer dat dan als beperking in plaats van een hoge score als productiegeschiktheid te presenteren.
| Testgeval | Verwacht gedrag | Bewijs |
|---|---|---|
| Eenduidig synthetisch ticket | Voorgestelde categorie binnen de allowlist. | Input-ID, typed resultaat en policybesluit. |
| Onvolledige of dubbelzinnige tekst | Naar menselijke review. | Reden voor fallback en geen toolactie. |
| Onbekende categorie of ontbrekend veld | Weigeren of review; nooit stilzwijgend doorlaten. | Validatiefout plus geblokkeerde route. |
| Prompt injection in tickettekst | De classificatie kan onzeker zijn; rechten blijven onveranderd. | Geen policywijziging of muterende call. |
| Geautoriseerde categorie maar onvoldoende gebruikersrecht | Tool weigert op basis van de echte autorisatiebron. | Denied call, zonder side effect. |
Een geslaagde evaluatieset bewijst alleen het gedrag voor die set en configuratie. Herhaal de controle bij wijziging van model, vraagtekst, categorieën, drempel, applicatiepolicy of toolrechten. Bewaar versie en resultaten zodat een toekomstige wijziging met dezelfde cases kan worden vergeleken.
Wat controleer je voor je echte data verstuurt?
TypeSafe’s privacybeleid zegt dat de dienst prompts, data, instructies en andere input verzamelt, niet gebruikt om modellen te trainen, persoonsgegevens zolang als redelijk nodig bewaart en de dienst vanuit de Verenigde Staten host. Dat zijn verklaringen van de leverancier; ze geven op zichzelf geen afgesproken verwijdertermijn of toestemming voor ieder type bedrijfsdata.
Begin daarom met volledig synthetische input en stuur zo weinig mogelijk context. Controleer voor persoonsgegevens of vertrouwelijke gegevens de toepasselijke verwerkersafspraken, regio, bewaartermijn, verwijderprocedure, subverwerkers en je eigen beveiligings- en privacybeleid. Neem geen klant- of productiegegevens op voordat die toets is afgerond. Log voor de eval alleen wat nodig is voor herhaling: versies, case-ID, beslissing, policyversie en resultaat; laat prompts en secrets weg.
Wanneer is deze gate bruikbaar?
Een typed beslismodel is het onderzoeken waard wanneer een specifieke classificatie of rubric nu handmatig of met een ongestructureerde prompt wordt uitgevoerd en je de kwaliteit daarvan op representatieve gevallen kunt beoordelen. Begin read-only en laat twijfel naar een mens gaan. Houd de bestaande handmatige route beschikbaar totdat de risico-eigenaar de foutgrenzen accepteert.
Stel invoering uit als je geen betrouwbare labels kunt maken, geen negatieve cases kunt testen, de modeluitkomst direct een onomkeerbare actie zou starten of de privacyvoorwaarden niet passen. Een eenvoudigere regel of menselijke review kan dan beter aansluiten bij het risico.
Lees ook de grenzen van een coding agent sandbox testen en een AI-agent testen met een minimale evalset. De kernpagina AI-engineering voor organisaties beschrijft de bredere ondersteuning voor toetsbare agentintegraties.
Bronnen
- TypeSafe AI Docs, Introduction, geraadpleegd 2026-10-08. Beschrijft de Choice-, Score- en Noul-vraagtypes en parallelle, onafhankelijke evaluatie op dezelfde state. Productdocumentatie; geen onafhankelijke nauwkeurigheidsmeting.
- TypeSafe AI Docs, Choice, geraadpleegd 2026-10-08. Beschrijft de keuze uit vaste opties en de velden choice, probabilities en confidence. Een teruggegeven confidence is niet hetzelfde als bewezen of universeel gekalibreerde juistheid.
- TypeSafe AI Docs, Score en Noul, geraadpleegd 2026-10-08. Beschrijven de score-op-rubric- en ja/nee-vraagvormen.
- TypeSafe AI, Privacy policy, geraadpleegd 2026-10-08. Beschrijft verwerking van Input, geen training op Input, bewaartermijn als “reasonably necessary” en hosting in de VS. Geen vaste bewaartermijn; controleer afspraken voor de beoogde gegevens.
- TypeSafe AI, Introducing System One Models & Jev, gepubliceerd 2026-09-15, geraadpleegd 2026-10-08. Leveranciersaankondiging; prestatietaal is niet als onafhankelijk bewijs of als claim in deze tutorial gebruikt.