Open source is geen doel op zichzelf
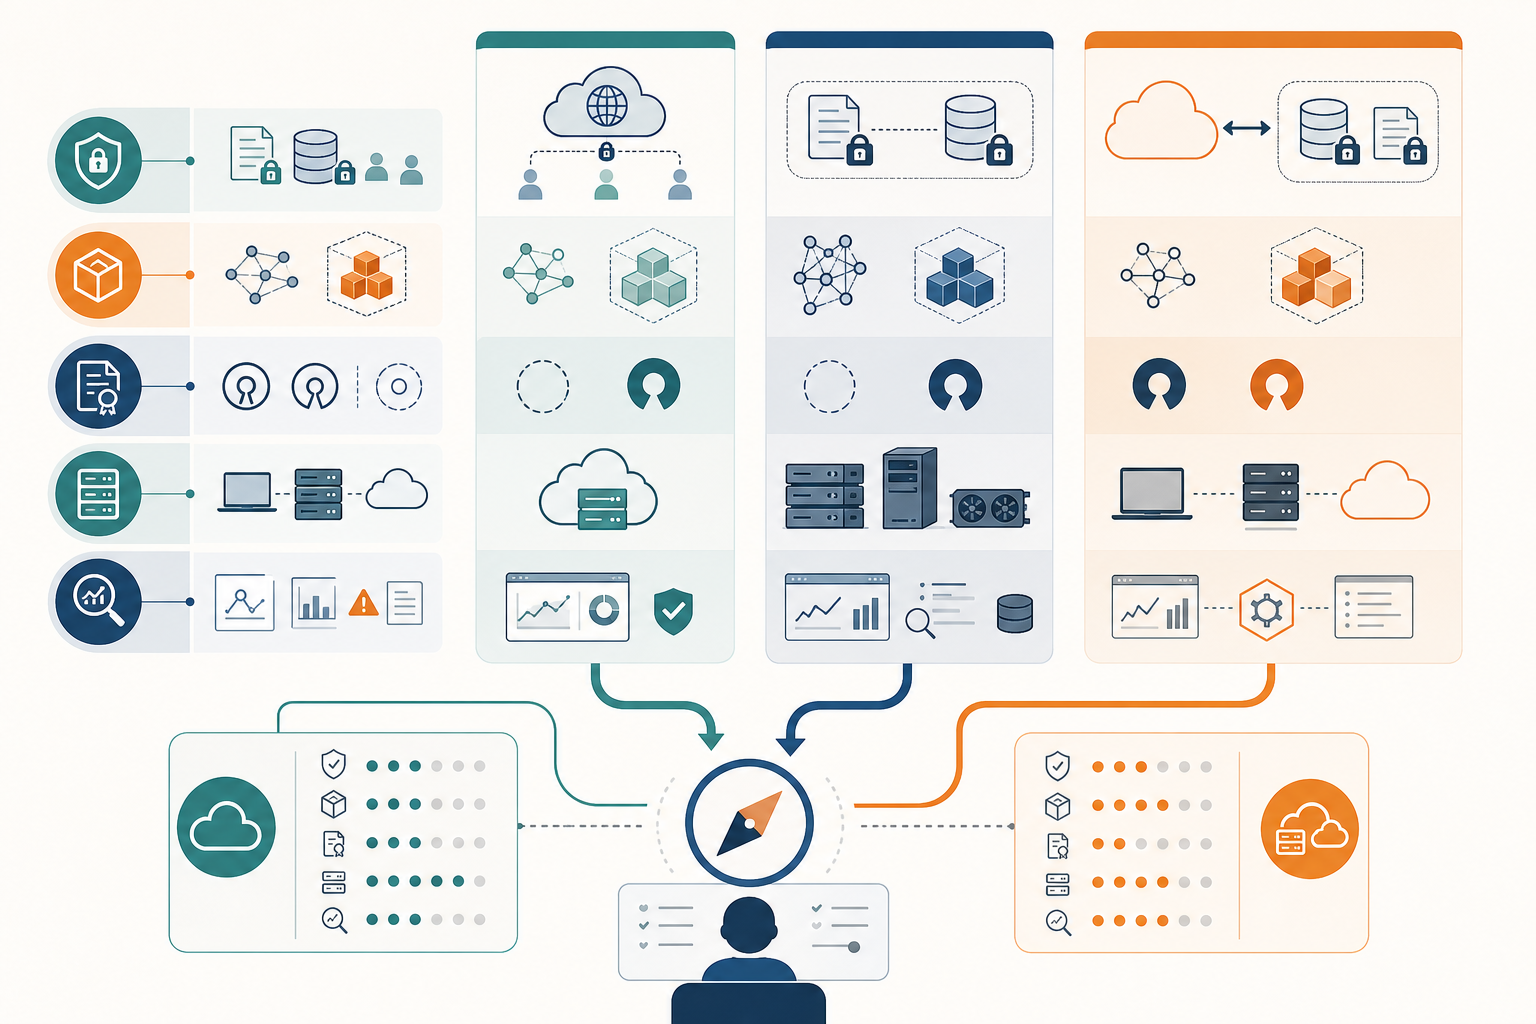
De vraag “kunnen we dit met een open model doen?” is vaak te vroeg. Eerst wil je weten welke gegevens het systeem verwerkt, welke responstijd nodig is en hoeveel fouten acceptabel zijn. Pas daarna kun je eerlijk vergelijken tussen een API, een zelf gehost model of een combinatie.
Een open model geeft je meer invloed op waar de data heen gaat en hoe de stack wordt ingericht. Maar die invloed komt met werk: infrastructuur, updates, beveiliging, monitoring en evaluatie worden onderdeel van je eigen verantwoordelijkheid.
Lokaal, open gewichten en open source zijn niet hetzelfde
Een model lokaal draaien zegt waar inference plaatsvindt. Open gewichten zegt dat je de gewichten kunt downloaden of gebruiken binnen de voorwaarden van de modellicentie. “Open source” vraagt daarnaast om een licentie die aan de relevante open-sourcecriteria voldoet. Controleer daarom modelkaart, licentie, gewichten, data en hosting als afzonderlijke onderdelen.
Wanneer het goed kan passen
Een stack met lokaal draaiende of open gewichten kan aantrekkelijk worden wanneer privacy, voorspelbare kosten of controle over latency zwaar wegen. Ook voor een afgebakende taak met een stabiel format kan een kleiner model meer dan genoeg zijn.
- De data mag of wil je niet naar een externe modelprovider sturen.
- De taak is smal genoeg om lokaal goed te evalueren.
- Je hebt een omgeving waarin inference en beheer al passen.
- Je verwacht genoeg volume om eigen infrastructuur te rechtvaardigen.
Dat zijn geen automatische argumenten voor open source. Ze zijn een aanleiding om de volledige kosten en risico’s naast elkaar te leggen.
Privacy vraagt om precieze keuzes
“Lokaal” en “privé” zijn geen synoniemen. Controleer waar modelgewichten, prompts, logging en afgeleide gegevens terechtkomen. Bepaal ook wie bij de endpoint kan en of verkeer via het publieke internet loopt.
Hugging Face maakt bijvoorbeeld onderscheid tussen publieke, beschermde en private Inference Endpoints. Zo’n instelling helpt, maar vervangt je eigen dataclassificatie, toegangsbeleid en bewaartermijnen niet.
Kwaliteit moet je zelf zichtbaar maken
Bij een externe API kun je snel wisselen tussen modellen en experimenteren. Bij een eigen stack moet je nog scherper weten wat “goed genoeg” betekent. Maak een kleine set echte voorbeelden, leg verwachte uitkomsten vast en test iedere wijziging tegen dezelfde set.
Zo voorkom je dat een modelkeuze vooral op gevoel wordt gemaakt. Soms blijkt een kleiner open model prima voor classificatie of extractie, terwijl een beheerde API verstandiger blijft voor complexe redenering. Een hybride architectuur kan praktischer zijn dan een ideologische keuze.
Mijn beslisregel
Ik kies open source wanneer de extra controle een concreet probleem oplost en het team de bijbehorende verantwoordelijkheid kan dragen. Als dat niet zo is, is een goede API geen minder serieuze oplossing — het is dan gewoon de meest passende infrastructuur.
Lees ook hoe je een modelkeuze terugbrengt naar een meetbare AI-workflow en hoe je controle in een productie-agent bouwt. Wil je de infrastructuurkeuze voor een eigen proces bespreken, neem dan contact op.
Bronnen
- Hugging Face Hub — Local Apps: officiële uitleg over lokale AI-toepassingen en de afwegingen rond privacy, snelheid, controle en kosten (geraadpleegd 21 augustus 2026).
- Hugging Face — Inference Endpoints: officiële beschrijving van modelgewichten, inference-engines en beheerde productie-infrastructuur (geraadpleegd 21 augustus 2026).
- Hugging Face — Endpoint Security: officiële documentatie over publieke, beschermde en private endpoints en gegevensverwerking (geraadpleegd 21 augustus 2026).
- Open Source Initiative — The Open Source Definition: de primaire definitie voor de criteria waaraan open-source-licenties moeten voldoen (geraadpleegd 21 augustus 2026).