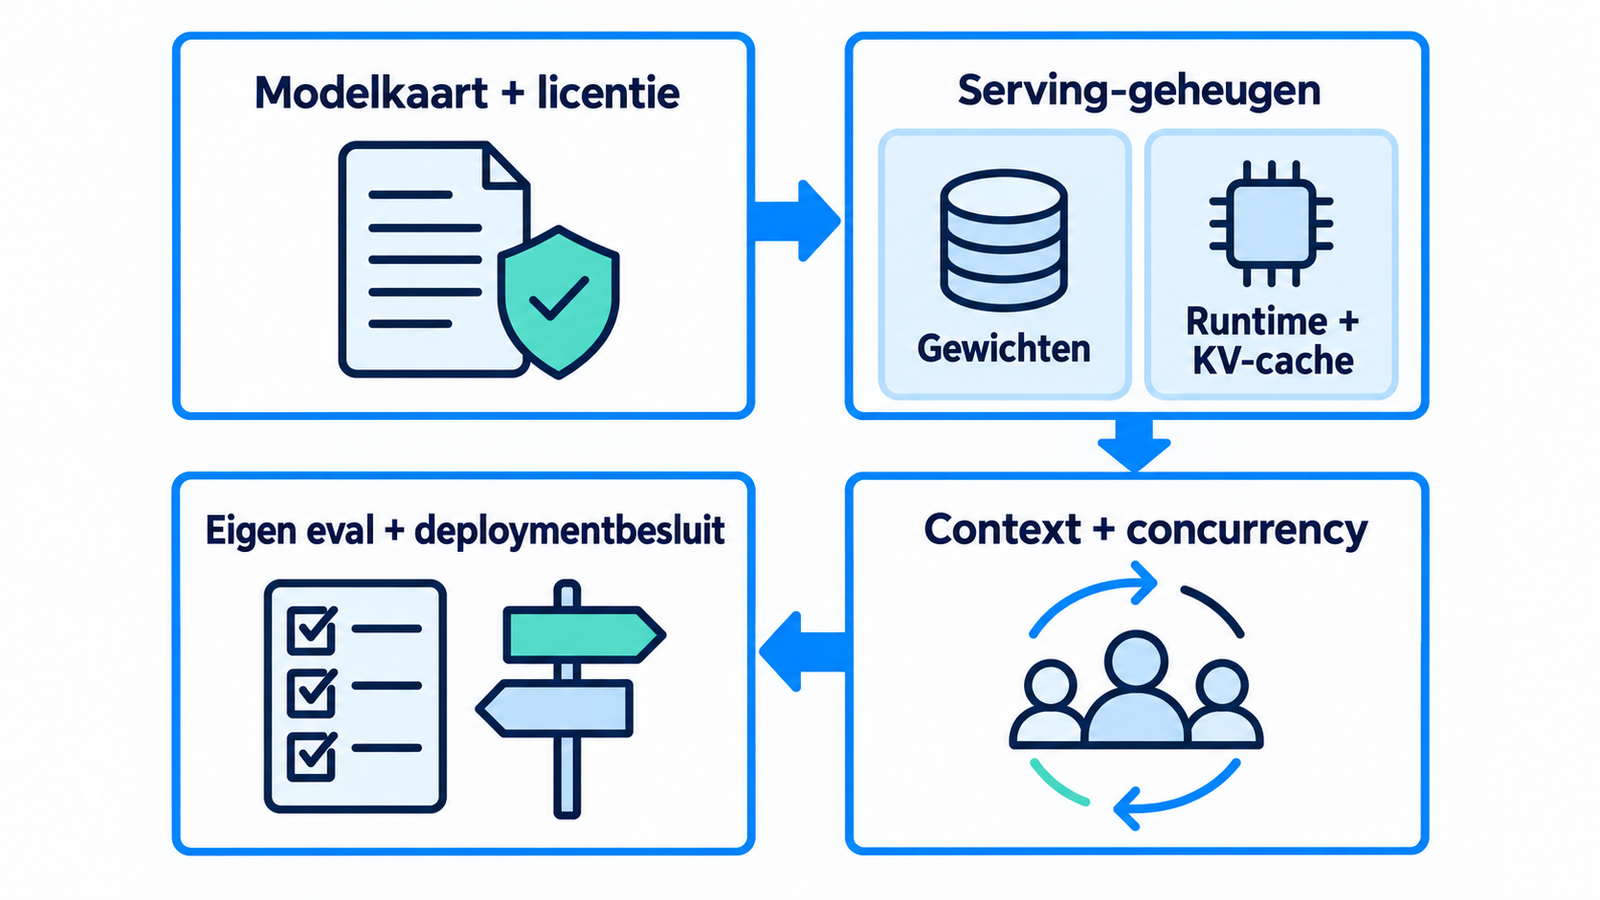
Aleph Alpha Kolibri-1 is een nieuw open-weight model. De naam “open” vertelt je nog niet of alle bijbehorende software en ontwikkelartefacten dezelfde gebruiksrechten hebben, en het maximale contextvenster vertelt je niet hoeveel GPU-geheugen een productie-opstelling nodig heeft.
Dit is een selectiechecklist op basis van openbare documentatie. Er is hier geen Kolibri-inference of benchmark gerapporteerd. De modelkaart en het technische rapport zijn afkomstig van de leverancier; gebruik ze voor productspecificaties, niet als onafhankelijke vergelijking van kwaliteit of snelheid.
Wat betekent “open-weight” bij Kolibri-1?
Behandel een modelrelease als meerdere onderdelen met mogelijk verschillende rechten:
- Modelgewichten en configuratie die in de modelrepository staan.
- Inferencecode en runtime, inclusief de server of plugin die de gewichten laadt.
- Overige artefacten, zoals tokenizerbestanden, code, scripts en documentatie.
- Trainingsdata en modelontwikkeling, die niet vanzelf onder de licentie van de gewichten vallen.
De Kolibri-1-modelkaart op Hugging Face vermeldt Apache License 2.0 voor de modelgewichten en configuratie in die repository. De kaart zegt ook expliciet dat andere artefacten, waaronder de onderliggende code, modelarchitectuur, parameterinstellingen en trainingsmethode, buiten die licentietoekenning vallen. Leid daar dus niet uit af dat de volledige trainingsdata, ontwikkelstack of iedere manier van herdistributie dezelfde voorwaarden heeft.
Maak voor je eigen use-case een korte rechteninventaris: welke bestanden download je, welke runtime gebruik je, geef je de dienst alleen intern of aan klanten, en verspreid of host je zelf iets? Controleer voor die concrete combinatie de licentieteksten en eventuele aanvullende voorwaarden. Bij twijfel over commerciële inzet is juridisch advies nodig; een modelkaart vervangt dat niet.
Hoeveel GPU-geheugen vraagt Kolibri-1?
De modelkaart noemt 78,1 miljard totale parameters en ongeveer 3,46 miljard actieve parameters per token. Het actieve aantal is geen maat voor de volledige opslagruimte van de gewichten. De modelkaart geeft voor FP8-gewichten ongeveer 78 GB op; dat is alleen een startpunt voor de geheugenbegroting.
Voor serving heb je daarnaast ruimte nodig voor onder meer de runtime, activaties, tijdelijke buffers en de key-value cache. Die cache groeit afhankelijk van contextlengte en gelijktijdige verzoeken. Kwantisering of verdeling over GPU’s kan de afweging veranderen, maar beïnvloedt mogelijk latency, kwaliteit, compatibiliteit en operationele complexiteit. Kies dus geen machine op basis van “3,46B actieve parameters” alleen.
Gebruik deze volgorde:
- Noteer de exacte repository-revisie en precision of quantisatie die je wilt draaien.
- Tel het gewichtengeheugen op bij runtime-overhead, cache en marge voor de gewenste concurrency.
- Controleer of de ondersteunde server en GPU-combinatie jouw gekozen variant daadwerkelijk kunnen laden.
- Meet piekgeheugen met de langste realistische prompt en met de verwachte gelijktijdigheid.
- Herhaal de meting na iedere wijziging in modelversie, runtime, quantisatie of concurrency.
De officiële inference-repository van Aleph Alpha beschrijft een ondersteunde integratie voor serving. De README vermeldt op de controledatum vLLM 0.29 als ondersteunde versie. Dat is een versiegebonden compatibiliteitsnotitie, geen bewijs dat jouw driver, GPU, deploymentconfiguratie en modelrevisie samen werken. Verifieer de actuele matrix wanneer je gaat implementeren.
Is het maximale contextvenster praktisch bruikbaar?
De modelkaart vermeldt een contextvenster tot 1.048.576 tokens. Voor serving beveelt de kaart maximaal 262.144 tokens aan voor efficiënter gebruik en complexe taken. Dat zijn twee verschillende getallen: de eerste beschrijft een maximum, de tweede een serving-aanbeveling van de leverancier.
Een lang contextvenster kan nuttig zijn als je taak veel bronmateriaal tegelijk nodig heeft. Het is geen reden om ieder verzoek maximaal lang te maken. Meer context kan de geheugendruk en responstijd verhogen, terwijl irrelevante passages het antwoord kunnen verslechteren. Begin daarom met de kleinste context die je taak aankan en voeg alleen meer toe wanneer je evaluatie laat zien dat belangrijke informatie anders ontbreekt.
Neem in je testset zowel een normale invoer als een lange invoer op. Controleer niet alleen of het model een antwoord geeft, maar ook of het de relevante passage vindt, onzekerheid benoemt wanneer bewijs ontbreekt en binnen de afgesproken latency blijft.
Hoe vergelijk je het model op je eigen werk?
Maak vóór de eerste run een vast evaluatiebestand. Kies geen verzameling voorbeelden nadat je al hebt gezien waar het model goed in is. Leg per geval vast:
| Veld | Voorbeeld van wat je vastlegt |
|---|---|
| Taak | Samenvatten, classificeren, extraheren of redeneren |
| Invoer | Goedgekeurde, synthetische of geredigeerde representatieve tekst |
| Gewenst resultaat | Verwachte velden, bronverwijzingen of rubric |
| Grens | Wat het model niet mag invullen of uitvoeren |
| Maatstaf | Juistheid, volledigheid, latency, geheugen en kosten |
| Versie | Modelrevisie, runtime, precision, prompt en hardware |
Vergelijk dezelfde cases met Kolibri-1 en een eenvoudiger alternatief dat je werkelijk zou inzetten. Beoordeel outputs met een vooraf bepaalde rubric; voor kritieke beslissingen laat je een mens de foutenklasse beoordelen. Registreer mislukte gevallen en herhaal ze bij iedere model- of promptwijziging. Voor een agenttoepassing hoort ook een aparte check voor toolkeuze en side effects bij de set. De bestaande uitleg over AI-agenten testen beschrijft hoe je een minimale evalset opzet.
Een fictieve evaluatie kan bijvoorbeeld twintig synthetische Duitstalige en Engelstalige supportvragen bevatten. Meet per run exactheid van geëxtraheerde velden, verzonnen informatie, p95-latency en piek-VRAM. Dit is een voorstel voor je eigen test, geen gerapporteerd Kolibri-resultaat.
Welke beslissing volgt uit de eval?
Kies het model alleen als de combinatie van rechten, kwaliteit, hardware en operationele eisen past. Een eenvoudige beslismatrix helpt:
- Rechten onduidelijk: pauzeer commerciële inzet en inventariseer alle artefacten en diensten.
- Kwaliteit onvoldoende op jouw cases: kies een ander model of pas de taakopzet aan; vergroot niet automatisch de prompt.
- Geheugen of latency buiten de grens: probeer een expliciet vastgelegde quantisatie of andere servingconfiguratie, en herhaal dezelfde evaluatie.
- Resultaat voldoende en reproduceerbaar: leg revisie, runtime, hardware, rubric en beperkingen vast voordat je opschaalt.
Het technische rapport, Kolibri: A Sovereign European Model on the Pareto Frontier, geeft aanvullende modelinformatie. Het is door de leverancier geschreven en is geen onafhankelijke benchmark. Vergelijk prestatieclaims daarom alleen met resultaten die je op gelijke taken, hardware, runtime en instellingen hebt gemeten.
Wat moet je vastleggen voordat je uitrolt?
Bewaar minimaal de modelrevisie, licentiecontrole, runtimeversie, gebruikte hardware, contextlimiet, concurrency, evaluatieset en gemeten resultaten. Leg ook vast wat er buiten scope valt: bijvoorbeeld geen persoonsgegevens in een demo, geen automatische acties op basis van een onbewezen extractie en geen claim dat een vendorbenchmark jouw productiewerk voorspelt.
Zo kun je later zien of een nieuwe modelversie, andere runtime of langere context je keuze nog steeds rechtvaardigt. Een korte, herhaalbare eval geeft daarvoor meer houvast dan het vergelijken van alleen parameter-aantallen of maximale contextlengtes.
Verder lezen
- Open-source AI: modellen, licenties en inzet
- AI-agenten testen met een minimale evalset
- AI-architectuur en modelkeuze
Bronnen en beperkingen
- Aleph Alpha, Kolibri has landed: a sovereign open-weight model, gepubliceerd 2026-10-03; geraadpleegd 2026-10-13. Leveranciersaankondiging; geen onafhankelijke prestatievalidatie.
- Aleph Alpha, Kolibri-1 model card, release-informatie 2026-10-03; geraadpleegd 2026-10-13. Productspecificaties en licentiebereik zoals gepubliceerd door de leverancier; controleer revisie en tekst opnieuw vóór gebruik.
- Aleph Alpha, Kolibri technical report, 2026-10-03; geraadpleegd 2026-10-13. Leveranciersrapport, geen onafhankelijke benchmark.
- Aleph Alpha, aleph-alpha-inference, geraadpleegd 2026-10-13. Compatibiliteit kan wijzigen; er is geen deployment of inference uitgevoerd.