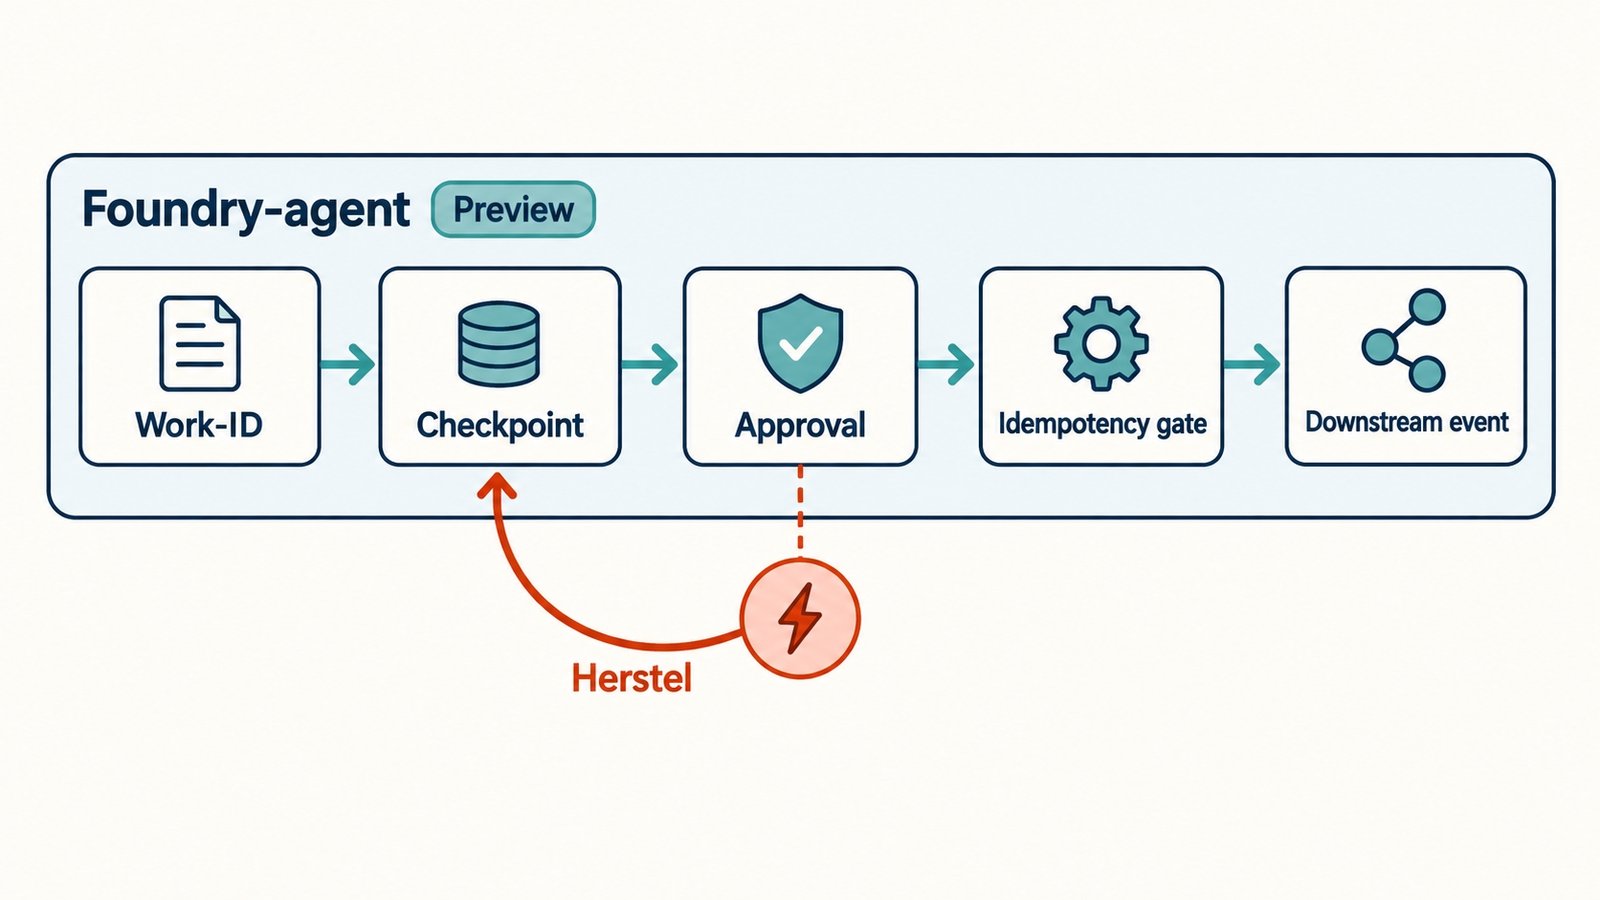
Bij Microsoft Foundry long-running agents krijgt een lange taak vroeg of laat te maken met een verbroken verbinding, redeploy of procescrash. De verkeerde reactie is vaak: “gewoon opnieuw proberen.” Als de agent net een factuur, order of bericht naar een extern systeem heeft gestuurd, kan een retry precies die actie herhalen.
De reference flow hieronder is een synthetische ordercontrole. Hij is niet in een Azure-tenant uitgevoerd en zegt niets over een persoonlijk klantproject. Juist daardoor kun je het ontwerp los van bedrijfsdata beoordelen.
Wat is het verschil tussen background work, resilience en een retry?
Background work houdt werk draaiend zonder dat de oorspronkelijke HTTP-verbinding open blijft. Resilience probeert een logische taak terug te krijgen na een procesverlies. Een retry probeert opnieuw nadat de actieve handler een fout meldt. Het zijn drie verschillende mechanismen met verschillende risico's.
Microsoft beschrijft in Resilience for long-running Microsoft Foundry hosted agents (preview) dat het platform een durable work identity, persisted inputs, lease recovery en stream replay kan bieden. De applicatie blijft verantwoordelijk voor betekenisvolle checkpoints en het voorkomen van dubbele externe effecten.
| Mechanisme | Helpt bij | Lost niet zelf op |
|---|---|---|
| Background work | Client disconnect | Procesverlies of side effects |
| Resilience | Crash, redeploy, leaseverlies | Workflowstate of elke externe actie |
| Retry | Fout die de handler teruggeeft | Onzekerheid of de actie al is gebeurd |
| Checkpoint | Weten welke fase klaar was | Authorization of businessgoedkeuring |
De Foundry-functies zijn op dit moment preview en zonder SLA. Ontwerp daarom een veilige applicatiegrens die ook bruikbaar blijft als een API, pakket of portalgedrag verandert.
Stap 1: geef werk en input elk een eigen identiteit
Een workId benoemt de logische taak, bijvoorbeeld één ordercontrole. Een inputId benoemt één concrete invoer of beurt binnen dat werk. Maak beide stabiel en traceerbaar, maar stop geen klantinhoud in de ID of runtime-metadata.
Voorbeeld van een kleine state-record:
{
  "workId": "ordercheck-7f3a",
  "inputId": "approve-01",
  "phase": "waiting_for_approval",
  "checkpointRef": "checkpoints/ordercheck-7f3a/phase-2",
  "idempotencyKey": "send-event:ordercheck-7f3a:v1",
  "eventWatermark": "not_sent",
  "approvalState": "pending"
}
Bewaar grote prompts, toolresultaten, documentinhoud en output in toepassingsopslag met encryptie, retentie en toegangscontrole. Microsoft raadt aan runtime-metadata klein te houden en te gebruiken als index of verwijzing, niet als checkpoint-store.
Stap 2: zet een checkpoint vóór de externe actie
Een checkpoint is geen volledige kopie van het procesgeheugen. Het is een duurzaam, betekenisvol punt waar je na herstel verder kunt. Kies het vóór een stap die niet veilig twee keer mag gebeuren.
In deze demo zijn de fasen:
- valideer de synthetische order;
- schrijf
validatedals checkpoint; - vraag approval;
- schrijf
approvedals checkpoint; - fence het downstream-event met een idempotency key;
- verstuur het event en schrijf
sentals checkpoint.
Recovery begint doorgaans niet midden in een lokale call stack. De handler leest bij herintrede daarom de laatst opgeslagen fase en voert alleen het nog ontbrekende stuk uit. De hosted agent runtime contract zegt eveneens dat foreground responses na procesverlies niet worden heringeroepen; kies dus bewust voor het protocol en gedrag dat je nodig hebt.
Stap 3: fence een side effect met idempotency en een watermark
Een side effect is een actie buiten de eigen geheugenruimte: een event publiceren, e-mail versturen, database-mutatie of betaling starten. Een checkpoint na die actie alleen is te laat: de crash kan precies tussen uitvoeren en opslaan vallen.
Gebruik waar mogelijk een downstream-API met idempotency. Zet daarnaast een watermark vóór de actie, of bewaar een status die recovery kan lezen. Dit is pseudocode; de gekozen opslag en foutafhandeling moeten bij jouw systeem passen.
async function sendApprovedOrder(state: State) {
  if (state.eventWatermark === "sent") return;

  await checkpoints.save({ ...state, eventWatermark: "sending" });

  await downstream.publish({
    orderId: state.workId,
    idempotencyKey: state.idempotencyKey,
  });

  await checkpoints.save({ ...state, eventWatermark: "sent", phase: "done" });
}
Bij herstel vraag je eerst de downstream-service of dezelfde key al een afgerond resultaat heeft. Alleen als die service dat contract biedt, kun je veilig concluderen dat opnieuw verzenden geen dubbel effect oplevert. Bestaat die mogelijkheid niet, zet de actie achter een human gate of ontwerp een compensatieproces.
Stap 4: pauzeer voor menselijke approval
Een approval is geen knop boven op een autonoom proces. Het is een expliciete status met eigenaar, context, vervaldatum en hervatpad. Laat de agent na het checkpoint stoppen in waiting_for_approval; start de volgende fase alleen met een nieuwe, gecontroleerde input.
De Microsoft-handleiding Add a human-in-the-loop approval step (preview) beschrijft dat een multi-turn task in suspended kan blijven en met hetzelfde task-ID kan hervatten. Gebruik dat mechanisme als technische pauze, maar leg in je eigen product ook vast wie mag goedkeuren en wat er gebeurt bij afwijzing of timeout.
Stap 5: test herstel vóór je op betrouwbaarheid vertrouwt
Een workflow is niet crash-resilient omdat een diagram dat zegt. Test gecontroleerd waar het fout mag gaan:
| Test | Verwachting | Controlepunt |
|---|---|---|
| Crash vóór checkpoint | Validatie mag veilig opnieuw | Geen downstream-event |
| Crash na checkpoint | Hervat vanaf volgende fase | Checkpointref blijft gelijk |
| Crash tijdens side effect | Geen dubbel downstream-event | Eén idempotency key / event-ID |
| Approval komt tweemaal binnen | Slechts één hervatting | Statusovergang atomair |
| Redeploy tijdens streaming | Client kan status terugvinden | Work-ID en observatielog |
Log minstens workId, inputId, fase, checkpointversie, idempotency key, recovery-indicatie, approvalbesluit en stopreden. Log geen volledige orderinhoud wanneer dat niet nodig is. Dit is tegelijk je observabilityadvies en je privacygrens.
Wanneer gebruik je iets anders dan Foundry-resilience?
Kies een workflow-engine wanneer je fan-out/fan-in, durable timers, child workflows of complexe compensaties nodig hebt. Kies een gewone queueworker voor een korte, idempotente batch zonder gesprekstoestand. Kies géén autonome uitvoering wanneer de echte stap een juridisch, financieel of productbesluit is dat een mens moet nemen.
De extra storage, tracing en tests kosten tijd. De winst is dat een crash geen gok wordt over wat net is gebeurd. Voor het bredere ontwerp van controlepunten kun je ook lezen over AI-agenten in productie en LLM-workflows. Voor Azure-specifieke architectuur kun je een Azure AI engineer inschakelen.
Samenvatting
Microsoft Foundry long-running agents worden beheersbaar met een duidelijke grens: het platform herstelt de logische taak, de applicatie bewaart de voortgang en beschermt externe effecten. Ontwerp daarom work/input-ID's, checkpoints, idempotency en approvals samen. Test een crash vóór en ná ieder beslissend punt en behandel de huidige previewstatus als een reden voor extra validatie, niet als een SLA.
Bronnen
- Microsoft Learn, Resilience for long-running Microsoft Foundry hosted agents (preview), bijgewerkt 19 augustus 2026, geraadpleegd 11 september 2026. Beschrijft durable identiteit, recovery en de verdeling van platform- en applicatieverantwoordelijkheid; preview zonder SLA.
- Microsoft Learn, Hosted agent runtime contract, geraadpleegd 11 september 2026. Beschrijft container-, protocol- en adaptercontracten; geen bewijs dat een eigen agentworkflow foutvrij is.
- Microsoft Learn, Add a human-in-the-loop approval step (preview), bijgewerkt 19 augustus 2026, geraadpleegd 11 september 2026. Beschrijft suspension en resume op hetzelfde task-ID; geen volledige governance- of compliancegarantie.